- Giới thiệu
-
 Lưu trữ dữ liệu đối tượng không giới hạn và truy xuất dữ liệu liên tục
 Certified DBaaS (cơ sở dữ liệu theo dạng dịch vụ) đầu tiên của MongoDB tại Việt Nam
 Tích hợp với máy chủ ảo dành cho 3D Rendering, AI hay ML
 Nền tảng phân tích dữ liệu đáng tin cậy cho doanh nghiệp và chuyên gia, giúp tối ưu chi phí vận hành lên đến 40% so với giải pháp BI khác.
 Sản phẩm hợp tác giữa FPT Cloud và CyRadar, cung cấp dịch vụ tường lửa với khả năng bảo vệ mạnh mẽ cho các ứng dụng web
 Sản phẩm hợp tác giữa FPT Cloud và CyRadar, dịch vụ cung cấp khả năng rà quét toàn diện, phân tích chi tiết và đánh giá lỗ hổng bảo mật để tăng cường an ninh thông tin cho hệ thống ứng dụng doanh nghiệp
 Sao lưu và khôi phục dữ liệu tức thời, an toàn và toàn vẹn dữ liệu
 Trở thành doanh nghiệp đầu tiên trải nghiệm bộ giải pháp phát triển AI toàn diện, được phát triển trên công nghệ mạnh mẽ bậc nhất từ NVIDIA!
 Giải pháp làm việc từ xa hiệu quả và an toàn cho doanh nghiệp
 Dịch vụ máy chủ ảo tiên tiến với khả năng mở rộng nhanh chóng
 Hiệu năng mạnh mẽ với hạ tầng riêng biệt
Tích hợp với máy chủ ảo dành cho 3D Rendering, AI hay ML
Dịch vụ máy chủ ảo tiết kiệm đến 90% chi phí cho doanh nghiệp
Sao lưu và khôi phục dữ liệu tức thời, an toàn và toàn vẹn dữ liệu
Dịch vụ dự phòng & khôi phục hệ thống nhanh chóng
Lưu trữ khối đa dạng thông lượng và dung lượng cho mọi nhu cầu
Lưu trữ dữ liệu đối tượng không giới hạn và truy xuất dữ liệu liên tục
Nâng cao năng lực, tính sẵn sàng của ứng dụng
Nền tảng tự động hoá bảo mật trong quy trình phát triển phần mềm
Sản phẩm hợp tác giữa FPT Cloud và CyRadar, dịch vụ cung cấp khả năng rà quét toàn diện, phân tích chi tiết và đánh giá lỗ hổng bảo mật để tăng cường an ninh thông tin cho hệ thống ứng dụng doanh nghiệp
Sản phẩm hợp tác giữa FPT Cloud và CyRadar, cung cấp dịch vụ tường lửa với khả năng bảo vệ mạnh mẽ cho các ứng dụng web
Dịch vụ tường lửa thông minh cho các ứng dụng web - Giải pháp bảo mật đột phá với sự hợp tác giữa FPT Cloud và Penta Security. Liên tục giám sát, tự động phát hiện lỗi cấu hình trên hạ tầng FPT Cloud mà không cần cài đặt agent.
 Dịch vụ bảo mật tường lửa thế hệ mới
Lưu trữ, quản lý, và bảo mật các Docker Images
Nền tảng Kubernetes an toàn, bảo mật, ổn định, hiệu năng cao
 Tăng tốc phát triển ứng dụng yêu cầu hiệu năng cao bằng dịch vụ Kubernetes tích hợp với vi xử lý cao cấp GPU
Giám sát và triển khai cơ sở dữ liệu như Kafka,..
Certified DBaaS (cơ sở dữ liệu theo dạng dịch vụ) đầu tiên của MongoDB tại Việt Nam
Giám sát và triển khai cơ sở dữ liệu Redis, Cassandra, ...
Giám sát và triển khai cơ sở dữ liệu xử lý phân tích trực tuyến
Giám sát và triển khai cơ sở dữ liệu MySQL, Postgres, SQLserver, MariaDB,...
Giám sát và triển khai cơ sở dữ liệu truy vấn thông tin
Giám sát và triển khai cơ sở dữ liệu chuỗi thời gian
Giám sát hệ thống và tài nguyên toàn diện trên mọi nền tảng Giải pháp quản lý sự cố thông minh
 Dịch vụ cung cấp giải pháp khởi tạo và quản lý FPT ArgoCD được tạo ra từ dự án mã nguồn mở Argo
 Tăng cường khả năng quản lý tài sản dữ liệu doanh nghiệp
 Quản lý dữ liệu liền mạch & toàn diện
Truy vấn, quản lý, trực quan hóa dữ liệu hiệu quả
Tăng tốc độ xử lý, đảm bảo tính nhất quán cho ứng dụng
Nền tảng phân tích dữ liệu đáng tin cậy cho doanh nghiệp và chuyên gia, giúp tối ưu chi phí vận hành lên đến 40% so với giải pháp BI khác.
Trở thành doanh nghiệp đầu tiên trải nghiệm bộ giải pháp phát triển AI toàn diện, được phát triển trên công nghệ mạnh mẽ bậc nhất từ NVIDIA!
Nền tảng hội thoại thông minh gắn kết khách hàng trên mọi nền tảng
Xác thực nhanh chóng, dễ dàng, tối ưu chi phí
Nâng tầm trải nghiệm khách hàng
Trích xuất dữ liệu vượt mọi giới hạn
Chuyển văn bản thành giọng nói tiếng Việt với ngữ điệu tự nhiên.
- Bảng giá
- Sự kiện
Blogs Tech
Danh mục
Các chuyên gia viết chia sẻ kiến thức – FPT CLoud
Hyperscaler mở local zone Việt Nam: Giá trị khác biệt của sovereign cloud nội địa
18:14 15/09/2026
Ngày 19/06/2026, AWS đưa Local Zone Hà Nội vào vận hành chính thức1. Hạ tầng này giải quyết đúng hai việc AWS công bố: độ trễ mili giây một chữ số cho workload hướng người dùng trong nước, và lưu trữ dữ liệu tại chỗ để đáp ứng yêu cầu residency. Đây chưa phải một AWS Region đầy đủ tại Việt Nam: Local Zone là phần mở rộng của parent Region Singapore và chỉ cung cấp một tập dịch vụ nhất định.2 Một hạ tầng có Control Plane phụ thuộc ra nước ngoài thì dù dữ liệu ở Hà Nội vẫn chưa thể coi là sovereign cloud hoàn toàn. Nhưng chính cấu hình này đã tạo ra một bài kiểm tra áp lực chiến lược (stress test) đáng đưa vào kế hoạch hạ tầng 3-5 năm: nếu trong tương lai một hyperscaler mở full Region tại Việt Nam, nhà cung cấp trong nước còn khác biệt ở đâu ngoài vị trí dữ liệu?
Động lực thị trường cho sovereign cloud đang tăng. Gartner ước tính chi tiêu IaaS sovereign cloud toàn cầu đạt 80 tỷ USD năm 2026, tăng 35,6%; riêng châu Á - Thái Bình Dương mới nổi tăng 76%, và hãng dự báo một phần workload sẽ dịch chuyển từ nhà cung cấp toàn cầu sang nhà cung cấp địa phương.3 Bất kể kịch bản full Region tại Việt Nam xảy ra khi nào, Local Zone Hà Nội đã đủ để buộc các quyết định phân bổ ngân sách cloud nội địa phải dựa trên nhiều yếu tố hơn thay vì chỉ xét đến vị trí đặt dữ liệu.
Lưu trữ dữ liệu tại chỗ mới chỉ là điểm bắt đầu, chưa phải toàn bộ bài toán chủ quyền
Khung pháp lý Việt Nam không quy định chung chung rằng 'mọi dữ liệu phải ở trong nước', mà phân loại cụ thể theo từng loại dữ liệu và chủ thể:
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 (hiệu lực 01/01/2026)4 và Nghị định 356/2025/NĐ-CP đặt yêu cầu đối với hoạt động chuyển dữ liệu cá nhân xuyên biên giới, bao gồm nghĩa vụ đánh giá tác động trong các trường hợp thuộc phạm vi áp dụng.
Luật Dữ liệu số 60/2024/QH15 (hiệu lực 01/7/2025)5 thiết lập cơ chế quản lý riêng đối với dữ liệu quan trọng và dữ liệu cốt lõi, cần đánh giá trước khi chuyển/cung cấp dữ liệu ra nước ngoài.
Luật An ninh mạng số 116/2025/QH15 (hiệu lực 01/7/2026) 6 đặt ra yêu cầu về lưu trữ dữ liệu tại Việt Nam trong các trường hợp thuộc phạm vi điều chỉnh, không phải yêu cầu đồng nhất đối với mọi loại dữ liệu/workload.
Chính AWS cho thấy residency chưa đồng nghĩa với sovereignty: ngày 15/1/2026, hãng khai trương European Sovereign Cloud với pháp nhân riêng, nhân sự vận hành cư trú tại EU và hạ tầng tách biệt vật lý lẫn logic khỏi các region hiện hữu.7 Tiền lệ này cho thấy vị trí dữ liệu chỉ là một lớp của sovereignty. Nó không cho phép suy ra một full Region tương lai tại Việt Nam sẽ có cấu trúc pháp nhân, control plane hay mô hình vận hành nào; các yếu tố đó phải được kiểm tra theo thiết kế và điều khoản của từng nhà cung cấp.
Dù hyperscaler có mở full Region tại Việt Nam, hai giá trị cốt lõi của Sovereign cloud nội địa vẫn không tự mất đi.
Giá trị thứ nhất: kiến trúc may đo và tổng chi phí sở hữu dự đoán được
Hyperscaler cung cấp dịch vụ được chuẩn hóa ở quy mô toàn cầu. Chuẩn hóa tạo ra quy mô và catalogue rộng, nhưng không phải mọi yêu cầu đặc thù đều được phản ánh trực tiếp trong mô hình dịch vụ và thương mại tiêu chuẩn. Trong phát biểu tại tọa đàm Vietnam Cloud & Datacenter Convention 2026, tôi nêu ngân hàng, tài chính và khu vực công là những nhóm có thể cần kiến trúc hybrid thiết kế theo hiện trạng và mô hình thương mại linh hoạt hơn. Flexera ghi nhận 73% tổ chức đang vận hành hybrid cloud trong báo cáo State of the Cloud 2026: Hybrid Cloud không phải là trạng thái quá độ tạm thời, mà là mô hình kiến trúc đích của các tập đoàn lớn.
Trong phần stress test tại Vietnam Cloud & Datacenter Convention 2026, tôi nêu ba yếu tố FPT Cloud hướng tới để khớp với nhu cầu đó: SLA tùy chỉnh theo thỏa thuận, khả năng đáp ứng yêu cầu chủ quyền dữ liệu tại địa phương ngay trong dịch vụ, và chi phí tối ưu không kèm phí egress khó dự đoán hay phí ẩn.
Cấu phần chi phí cần đọc kỹ hơn bảng giá niêm yết. Flexera 2026 đo lãng phí cloud ở mức 29%; 76% doanh nghiệp lớn trong khảo sát chi trên 5 triệu USD mỗi tháng cho public cloud. 8 Ở quy mô Enterprise, chi phí Cloud đủ lớn và phức tạp để TCO 3 - 5 năm bắt buộc phải tính thêm data movement, egress, connectivity, integration, migration và nhân sự vận hành. Trong kiến trúc hybrid, lưu lượng trao đổi giữa cloud và hệ thống hiện hữu có thể trở thành một cấu phần biến động đáng kể; vì vậy doanh nghiệp cần mô hình hóa các kịch bản traffic thay vì chỉ đọc bảng giá niêm yết.
Giá trị thứ hai: Last-Mile Integrator và trách nhiệm vận hành đầu-cuối
Chiến lược tối ưu không phải là cạnh tranh hạ tầng, mà là đóng vai trò 'Last-Mile Integrator' - cầu nối giúp doanh nghiệp giữ các workload cốt lõi trên hạ tầng sovereign nội địa, đồng thời kết nối an toàn với các dịch vụ AI nâng cao của Hyperscaler.
Điểm khác biệt nằm ở trách nhiệm, không nằm ở sơ đồ. Khi sự cố vắt trải dài qua các hạ tầng khác nhau, câu hỏi quan trọng không chỉ là dịch vụ nào đang lỗi mà là ai chịu trách nhiệm đưa service trở lại trạng thái hoạt động. Một đầu mối chịu trách nhiệm toàn tuyến chỉ có giá trị nếu phạm vi đó được thể hiện rõ trong SLA, RACI, escalation path và điều khoản hợp đồng; nếu cuối cùng khách hàng vẫn phải tự phân xử giữa nhiều ticket theo ranh giới sản phẩm, việc tích hợp mới chỉ dừng lại ở mặt sơ đồ kiến trúc (topology) chứ chưa giải quyết được bài toán vận hành thực tế. Giá trị của nhà cung cấp nội địa vì thế phải được chứng minh bằng khả năng thực thi tại chỗ và chịu trách nhiệm xuyên môi trường, không phải bằng tuyên bố "local" đơn thuần.
Ba câu hỏi trước khi phân bổ lại ngân sách cloud
Doanh nghiệp nên ra quyết định dựa trên đặc tính của từng danh mục workload, thay vì phụ thuộc vào thương hiệu của nhà cung cấp. Ba câu hỏi cần trả lời bằng số liệu trước khi ký cam kết dài hạn:
Control boundary nằm ở đâu? Workload nào thực sự có yêu cầu về vị trí lưu trữ, xử lý, quyền truy cập hoặc control plane; căn cứ đó đến từ luật, quy định ngành hay chính sách risk nội bộ?
Tổng chi phí sở hữu 3-5 năm của từng phương án là bao nhiêu khi tính đủ compute, storage, data movement/egress, tích hợp, kết nối, migration và nhân sự vận hành? Biến số nào khó dự báo nhất?
Accountability boundary nằm ở đâu? Khi sự cố vắt qua ranh giới các môi trường, ai chịu trách nhiệm phục hồi service đầu-cuối, và cam kết đó nằm ở SLA, RACI hoặc điều khoản nào của hợp đồng?
Doanh nghiệp cần rà soát bản chất của từng workload theo ba câu hỏi trên có thể làm việc trực tiếp với đội ngũ solution architect của FPT Cloud để nhận đánh giá kiến trúc và mô hình chi phí cho từng nhóm hệ thống. Đặt lịch tư vấn tại đây:
Nội dung bài viết là thông tin kỹ thuật và tham khảo pháp lý, không phải tư vấn pháp lý.
Trương Văn Quang Kiến trúc sư giải pháp (Solution Architect), FPT Cloud
Phòng thủ chiều sâu cho agent AI: giới hạn blast radius khi prompt injection vượt qua bộ lọc
17:42 11/09/2026
Báo cáo OWASP GenAI LLM Top 10 2026 (OWASP - Open Worldwide Application Security Project, tổ chức quốc tế phi lợi nhuận về bảo mật ứng dụng) xác nhận: Prompt Injection tiếp tục đứng ở vị trí LLM01 đối với ứng dụng mô hình ngôn ngữ lớn (LLM). Điểm đáng chú ý của bản 2026 không phải là kỳ vọng "lọc sạch" prompt độc hại, mà là chuyển trọng tâm sang thiết kế hệ thống để giới hạn hậu quả khi mô hình bị đánh lừa.1
"Đừng cố xây dựng một mô hình không thể bị đánh lừa. Hãy xây hệ thống xung quanh nó để khi mô hình bị đánh lừa - và điều đó sẽ xảy ra - không có gì quan trọng bị phá vỡ."2
Câu hỏi kỹ thuật đặt ra: nếu không thể chặn triệt để prompt injection ở tầng đầu vào, kiến trúc phải thay đổi ở đâu để một ca tấn công thành công chỉ gây thiệt hại trong phạm vi lường trước?
Bài toán dữ liệu sự cố và sự thất bại của bộ lọc đầu vào
Báo cáo năm 2026 dựa trên phân tích 7.714 sự cố an ninh AI thực tế trong đó 6.639 sự cố đủ chi tiết để phân loại.3 Dữ liệu cho thấy sự dịch chuyển rõ rệt khi thiệt hại không còn nằm ở nội dung LLM tạo ra, mà ở hành động AI Agent thực thi, hạng mục excessive agency (trao quyền quá mức) tăng lên vị trí thứ 3.
Nguyên nhân bộ lọc đầu vào không phải là ranh giới tin cậy
Mặc dù các API LLM hiện đại đã phân tách vai trò (system, user, tool) và huấn luyện mô hình ưu tiên chỉ dẫn hệ thống, đây thuần túy là hành vi học được (learned behavior) thay vì một ranh giới cưỡng chế (enforced boundary). LLM vẫn xử lý cả câu lệnh lẫn dữ liệu truy xuất trên cùng một không gian ngữ cảnh xác suất (probabilistic context window), do đó hoàn toàn thiếu một trust boundary đúng nghĩa ở tầng giao thức. Khác với SQL injection nơi parameterized queries phân tách tuyệt đối mã lệnh và dữ liệu về mặt cú pháp, LLM chưa tồn tại cơ chế phòng ngự tương đương có tính tổng quát. Tài liệu OWASP thừa nhận chưa rõ có tồn tại phương pháp phòng ngừa tuyệt đối hay không. 4
Thực nghiệm độc lập năm 2025 trên 6 hệ guardrails thương mại và mã nguồn mở cho thấy kết quả đồng nhất: kỹ thuật giấu chỉ dẫn trong Emoji qua mặt bộ lọc với tỷ lệ 100%; ký tự Unicode đặc biệt vượt rào trên 90%; và không có giải pháp nào chống chịu được toàn bộ các kỹ thuật tấn công. Ngay cả ProtectAI v2 - giải pháp cải thiện mạnh nhất ở nhóm giấu ký tự (giảm tỷ lệ lọt từ 77,32% xuống 20,26%) vẫn để lọt hơn 1/5 số mẫu prompt injection trong chính nhóm này. 5
EchoLeak (CVE-2025-32711) trên Microsoft 365 Copilot là minh chứng thực tế cho indirect prompt injection trên hệ thống production. Kẻ tấn công chỉ cần gửi một email được chế tác để vượt bộ phân loại XPIA; khi Copilot về sau truy xuất email đó trong một truy vấn bình thường, chuỗi khai thác có thể khiến Copilot đưa dữ liệu nhạy cảm vào một URL/tham chiếu hình ảnh và tạo yêu cầu ra ngoài. Điểm quan trọng là đây là kịch bản zero-click: nạn nhân không cần mở hoặc bấm vào email độc hại; việc sử dụng Copilot bình thường có thể đủ để kích hoạt chuỗi tấn công.
Bảng 1. Lọc đầu vào: dùng để làm gì và không nên kỳ vọng gì
Lọc đầu vào LÀM ĐƯỢC Lọc đầu vào KHÔNG làm được Giảm nhiễu và chi phí: chặn một phần mẫu tấn công đã biết hoặc ít tinh vi trước khi đi vào các lớp xử lý sâu hơn. Tạo bảo đảm an toàn hoặc trust boundary: mẫu mới, biến thể/adaptive attack và dữ liệu gián tiếp vẫn có thể vượt qua. Tạo tín hiệu giám sát: log các mẫu bị chặn cho thấy ai đang thử tấn công Thay thế kiểm soát quyền: khi mẫu lọt qua thì mô hình vẫn giữ nguyên toàn bộ quyền được cấp Tăng chi phí tấn công và bổ sung cho model hardening, output checking, red teaming. Tạo miễn nhiễm với indirect/cross-modal prompt injection: EchoLeak cho thấy classifier chuyên dụng vẫn có thể bị bypass.
Tổ hợp "Lethal Trifecta" và nguyên lý Blast Radius
Theo Simon Willison, rủi ro lớn nhất xảy ra khi một AI Agent hội đủ 3 yếu tố mà ông gọi là “bộ ba chết người" (Lethal Trifecta) bao gồm:
Truy cập dữ liệu nhạy cảm/nội bộ.
Tiếp nhận/xử lý dữ liệu không tin cậy từ bên ngoài (email, web, file).
Có kênh giao tiếp hoặc gửi dữ liệu ra môi trường ngoài.
Khi cả 3 yếu tố hội tụ trong cùng một context, một ca injection thành công đồng nghĩa với sự cố rò rỉ dữ liệu (data exfiltration). Vì thế khi thiết kế kiến trúc bảo mật cho AI Agent cần đặt mục tiêu thu hẹp tối đa blast radius (Phạm vi thiệt hại) khi Agent bị chiếm quyền điều khiển.
Kiến trúc bảo mật phòng thủ chiều sâu (Defense-in-Depth)
Tầng 1: Tách biệt danh tính (workload identity)
Khoảng trống phổ biến là để AI Agent sử dụng trực tiếp session/token của end-user hoặc một service account có phạm vi quyền quá rộng. Đây không mặc nhiên là "privilege escalation"; vấn đề là agent có thể thừa hưởng tập quyền hiệu lực quá lớn so với nhiệm vụ cần thực hiện. Nếu bị prompt injection, phạm vi thiệt hại có thể mở rộng tới toàn bộ tài nguyên mà token đó truy cập được.
Kiến trúc đề xuất: cấp workload identity riêng cho runtime của từng agent hoặc từng nhóm tác vụ. Khi agent hành động thay người dùng, sử dụng cơ chế on-behalf-of/scoped delegation với token ngắn hạn và downscope. Quyền thực tế nên là giao của ba lớp: quyền người dùng, capability được cấp cho agent và policy của tài nguyên; tuyệt đối không đưa raw user token vào prompt/context.
Quản lý credential: ưu tiên workload identity/federation và token ngắn hạn thay cho API key tĩnh. Secret còn cần thiết phải lưu trong vault và chỉ được tool runner/broker lấy tại thời điểm thực thi. LLM chỉ tạo ý định hoặc tool call; credential không được xuất hiện trong prompt, model context, log hoặc output của mô hình.
Tầng 2: Sandbox Tool-Calling - LLM đề xuất, Broker thực thi
Áp dụng nguyên tắc cô lập: LLM không gọi API trực tiếp, chỉ đề xuất cấu trúc gọi lệnh (intent declaration). Một Broker độc lập nhận khai báo từ LLM, thẩm định tham số (input schema validation), áp dụng danh sách cho phép (allowlist) cho kết nối mạng của từng công cụ, và khởi chạy tác vụ trong môi trường cách ly (sandbox) với quyền truy cập tệp và mạng bị giới hạn.7
Tầng 3: Tách biệt luồng tin cậy (mô hình CaMeL của Google DeepMind)
Kiến trúc CaMeL (2025) của Google DeepMind tách đôi vai trò của mô hình: một mô hình đặc quyền (Privileged Model) nhận yêu cầu của người dùng và lập kế hoạch nhưng không bao giờ đọc dữ liệu không tin cậy, còn một mô hình cách ly (Isolated Model) đọc dữ liệu không tin cậy nhưng không được gọi công cụ, API.
Mỗi biến dữ liệu mang nhãn nguồn gốc (data lineage tagging), và chính sách dòng dữ liệu (data flow policy) quyết định nguồn nào được phép chảy vào hành động nào.8
Tầng 4: Con người kiểm soát đầu ra & phê duyệt tác động (Human-in-the-Loop)
Mọi thứ LLM sinh ra cần được đối xử như đối với dữ liệu không tin cậy (Untrusted Output): kiểm tra, mã hoá và làm sạch (encode/sanitize) trước khi hiển thị hoặc đưa vào luồng xử lý tiếp theo.
Với các hành động đặc quyền làm thay đổi hệ thống production, nhất là các hành động không thể khôi phục thì con người luôn phải là chốt chặn kiểm soát cuối cùng.
Tại FPT Cloud, các agent phân tích dữ liệu hiện được giới hạn ở tác vụ đọc/tổng hợp; các hành động làm thay đổi production như chặn IP, vô hiệu hóa tài khoản, thay đổi firewall hoặc xóa dữ liệu chưa được phép tự động thực thi nếu chưa có phê duyệt của người có thẩm quyền. Đây là baseline an toàn phù hợp trong giai đoạn đầu; về sau chỉ nên tự động hóa các hành động low-risk, reversible và đã được policy phê duyệt trước.
Bảng kiểm tra an ninh AI Agent trước khi lên production
(Production Security Checklist)
Stt Hạng mục kiểm tra Trạng thái 1 Agent dùng Workload Identity riêng, không mượn tài khoản User? 2 Credential/API Key được giấu hoàn toàn khỏi Prompt Context? 3 Token cấp cho Agent có vòng đời ngắn và cơ chế Revoke tức thì? 4 Danh sách Tool/API áp dụng nguyên tắc đặc quyền tối thiểu (Least Privilege) ? 5 Các Tool gọi ngoài có Allowlist kiểm soát kết nối Mạng/Domain riêng? 6 Đã rà soát và nhận diện các Agent hội đủ bộ ba "Lethal Trifecta"? 7 Dữ liệu không tin cậy (Email, Web, File) có xử lý ở luồng cô lập? 8 Đầu ra của LLM được Validate/Sanitize trước khi Render/Execute? 9 Các tác vụ Write/Delete trên môi trường Production bắt buộc có HITL? 10 Hệ thống SIEM/SOC có Alert riêng khi Agent có hành vi bất thường?
Sự đánh đổi về mặt kiến trúc (Architectural Trade-offs)
Tăng độ trễ (latency): tách đôi model nghĩa là hai lời gọi thay vì một; cộng với độ trễ của broker và kiểm tra schema thêm một lớp nữa.
Tăng approval fatigue: không nên bắt con người duyệt mọi tool call. HITL cần ưu tiên cho hành động đặc quyền, tác động lớn, khó khôi phục hoặc vượt risk threshold; các thao tác low-risk có thể tự động nếu được policy giới hạn chặt và có khả năng rollback.
Tăng chi phí: allowlist theo từng tool, danh tính theo từng agent, vòng đời token ngắn đều cần người vận hành và quy trình; retrofit lên hệ thống đã chạy khó hơn nhiều so với thiết kế từ đầu.
Khung pháp lý cho Agent AI tại Việt Nam
Sự tuân thủ cho các hệ thống AI Agent hiện được điều chỉnh bởi:
Luật Trí tuệ nhân tạo (Luật 134/2025/QH15, hiệu lực 01/3/2026) và Nghị định 142/2026/NĐ-CP (áp dụng từ 01/5/2026): phân loại hệ thống AI theo ba mức rủi ro.
Quyết định 33/2026/QĐ-TTg (hiệu lực 15/8/2026): ban hành Danh mục hệ thống AI có rủi ro cao.
Luật Bảo vệ dữ liệu cá nhân (Luật 91/2025/QH15): Ràng buộc trách nhiệm xử lý và rò rỉ dữ liệu cá nhân qua Agent.
Nội dung trên không phải tư vấn pháp lý; doanh nghiệp cần đối chiếu văn bản gốc cho trường hợp cụ thể.
3 việc doanh nghiệp có thể triển khai ngay trong tuần
Kiểm kê: toàn bộ agent đang chạy, tool từng agent gọi được và danh tính từng agent đang dùng.
Khoanh vùng: gắn nhãn các agent hội đủ bộ ba lethal trifecta để xử lý trước.
Thiết lập chốt chặn: trước khi có policy chi tiết, áp dụng default-deny đối với mọi hành động làm thay đổi production; bắt buộc HITL cho thao tác high-impact/irreversible. Chỉ mở tự động cho các thao tác low-risk, reversible sau khi đã có allowlist, giới hạn tham số, quota và rollback..
Đội kỹ thuật đang đưa agent LLM vào vận hành và muốn rà lại kiến trúc quyền, sandbox tool-calling và các chốt chặn theo khung OWASP 2026 có thể cùng rà trực tiếp trên sơ đồ hệ thống với đội chuyên gia bảo mật và AI của FPT Cloud.
Liên hệ với chúng tôi để được tư vấn chi tiết về các giải pháp, dịch vụ của FPT Cloud:
Hotline: 1800 6139
Email: support@fptcloud.com
Support: m.me/fptsmartcloud
Nguyễn Hải Nam
Trưởng Phòng Vận Hành và Triển khai bảo mật FPT Cloud

Hiểu đúng ranh giới lỗi của vùng khả dụng: hai dạng shared fate nằm ngoài Multi-AZ
09:38 08/09/2026
Railway là một PaaS (Platform-as-a-Service) cho developer: kết nối GitHub repo là tự động build, deploy và có database managed (Postgres, MySQL, Redis) mà không cần tự quản lý hạ tầng bên dưới. Để tránh phụ thuộc một cloud provider duy nhất, Railway chạy workload trên cả AWS, Google Cloud và cụm bare-metal riêng (Railway Metal). Sự cố Railway ngày 19/5/2026 diễn ra theo bốn mốc:
22:11 UTC, dashboard Railway bắt đầu trả lỗi 503.
22:19, nguyên nhân được xác định: tài khoản production trên Google Cloud bị tự động khóa không báo trước
22:29, quyền truy cập được khôi phục nhưng toàn bộ compute vẫn dừng.
22:35, cache định tuyến bắt đầu hết hạn. Máy chủ trên AWS và Railway Metal vẫn sống nhưng các edge proxy không dựng lại được bảng định tuyến vì network control plane API mà nó phụ thuộc nằm trên chính các máy trong Google Cloud, khiến workload khách hàng tràn ngập lỗi 404.
Railway sau đó xác nhận chính phụ thuộc này biến sự cố ở một nhà cung cấp thành sự cố toàn nền tảng. Phân tán hạ tầng ra nhiều nơi không đồng nghĩa với phân tán được ranh giới lỗi (failure boundary). Multi-AZ cần được hiểu trong cùng giới hạn đó: một cơ chế khoanh vùng sự cố, không phải một minh chứng rằng các thành phần trong hệ thống có tính độc lập.
Multi-AZ thực sự cô lập lớp lỗi nào
Vật lý: Vùng khả dụng (AZ) được thiết kế trước hết để cô lập lỗi tương quan theo vị trí vật lý: nguồn điện, làm mát, hạ tầng mạng và những thành phần cùng chịu tác động trong một khuôn viên. Nhưng tự thân điều đó chưa đủ để đảm bảo high availability, cần thêm 3 điều kiện đúng: locality, quorum và capacity.
Điều kiện để AZ phát huy tác dụng
Locality: Giá trị của thiết kế zonal định lượng được. Giả định một trong ba vùng hỏng hoàn toàn, tài nguyên phân bố đều: nếu dịch vụ gọi ngẫu nhiên qua các AZ (kiểu regional), một lần gọi chỉ còn 4/9 khả năng thành công, và với chuỗi gọi dài N bước, khả năng đó giảm dần theo (2/3)N. Nếu dịch vụ chỉ gọi trong cùng một vùng (kiểu zonal), khả năng thành công luôn giữ ở mức 2/3, bất kể chuỗi gọi dài bao nhiêu - nguyên tắc "ưu tiên gọi trong cùng AZ" này gọi là locality, giúp tránh rủi ro cộng dồn qua từng bước gọi. Nhưng cả hai công thức trên đều giả định các AZ hoàn toàn độc lập với nhau - đây là điều kiện cần, chưa đủ để đảm bảo high availability.
Quorum và capacity: Cụ thể, dù đã chạy trên nhiều vùng, high availability vẫn chưa được đảm bảo do hai yếu tố thường bị bỏ sót:
Quorum: cluster 3 node đặt theo cấu hình 2+1 (2 node cùng một AZ, 1 node ở AZ khác) không chịu được mất AZ đang chứa 2 node đó. AZ đó sập nghĩa là mất quorum, vì chỉ còn 1 node, dưới ngưỡng đa số (2/3). Để chịu được mất bất kỳ AZ nào trong số 3 AZ, phải đặt đúng 1 node/AZ (cấu hình 1+1+1), không dồn 2 node vào cùng 1 AZ.
Capacity (static stability): nếu capacity dự phòng chỉ được provision sau khi một AZ đã sập (dynamic scale-up), việc phục hồi lại phụ thuộc đúng vào control plane thứ đang chịu tải cao nhất lúc đó, nên dễ chậm hoặc kẹt. Static stability yêu cầu cấp phát sẵn capacity dư từ trước khi có sự cố: với 3 AZ, mỗi AZ chỉ vận hành ở ~66% tải đã test (tức dư khoảng 50% headroom); mất 1 AZ, 2 AZ còn lại nhận thêm tải ngay không cần chờ tạo máy mới.
Giới hạn: nơi Multi-AZ không còn bảo vệ
Giả sử cả ba điều kiện trên: locality, quorum, capacity đều đã đúng, vẫn còn một lớp phụ thuộc chưa được tính tới: control plane dùng để vận hành chính các AZ đó, đây là hạ tầng nằm phía trên ranh giới AZ. Dù có bao nhiêu AZ, chúng vẫn thường dùng chung một control plane duy nhất để điều phối (DNS, orchestration, network state). Khi control plane này gặp lỗi, tất cả AZ bên dưới đều bị ảnh hưởng cùng lúc, bất kể locality, quorum hay capacity đã cấu hình đúng. Hai dạng shared fate - tình trạng các thành phần đặt ở AZ khác nhau nhưng vẫn cùng sập chung vì chia sẻ một điểm phụ thuộc nào đó, trình bày dưới đây là hai trường hợp điển hình:
Shared fate #1: Control Plane nằm phía trên ranh giới của AZ
Bản chất: Nhân bản (Replication) không đồng nghĩa với tính độc lập. Nhiều bản sao đặt tại các AZ khác nhau vẫn sẽ chung số phận nếu cùng phụ thuộc vào một shared state, một Single point of failure, hay một control plane ở tầng cao hơn.
Thực tế:
Railway: Dù ứng dụng và hạ tầng mạng được phân tán qua AWS, Google Cloud lẫn Railway Metal, việc phát hiện workload lại phụ thuộc hoàn toàn vào một Control Plane API duy nhất trên Google Cloud. Kiến trúc trông có vẻ phân tán, nhưng điểm phụ thuộc lại mang tính tập trung. Route cache hết hạn sau ~1 giờ; tổng downtime kéo dài 8 giờ
AWS DynamoDB (20/10/2025): 3 tiến trình DNS Enactor chạy độc lập trên 3 AZ nhưng lại cùng thao tác lên một DNS state cấp Region. Một Enactor bị trễ đã ghi đè DNS plan cũ lên plan mới; cleanup process sau đó xóa nhầm bản cũ (lúc này đang là bản thực thi), gỡ toàn bộ IP khỏi DNS. Kết quả: 3 Enactor ở 3 AZ hoàn toàn vô dụng vì quyết định cuối cùng lại nằm ở shared DNS state
Shared fate #2: Blast Radius của cấu hình vượt ranh giới hạ tầng vật lý
Bản chất: Cô lập vật lý không bảo vệ hệ thống trước một cấu hình lỗi được phát tán đồng loạt. Blast Radius của cấu hình tỷ lệ thuận với phạm vi quyền hạn của nó, không bị giới hạn bởi ranh giới địa lý. Đáng cảnh giác nhất là các self-healing mechanism: phản ứng càng nhanh và rộng thì sức tàn phá càng lớn khi đánh giá sai.
Thực tế:
Azure (2/2/2026): Workflow khắc phục tự động áp nhầm chính sách tắt anonymous access lên nhóm Storage Account phục vụ hạ tầng (chứa gói extension của VM). Khâu đánh giá tình trạng không phát hiện trạng thái nhắm sai đủ sớm, chính sách này lan ra nhiều vùng địa lý public cloud khiến hàng loạt VM, AKS và dịch vụ phụ thuộc bị tê liệt Control Plane trong nhiều giờ. Pha rollback sau đó gây quá tải Managed Identities ở East US/West US thêm ~6 giờ — bản thân remediation cũng tạo blast radius riêng
Cloudflare (18/11/2025): Một permission change trên ClickHouse tạo ra các dòng metadata trùng lặp, khiến feature file của Bot Management vượt hard limit (từ ~60 lên >200). File này lập tức đồng bộ toàn mạng, kích hoạt sự cố proxy panic trên diện rộng. Vì file được regenerate mỗi 5 phút trong lúc cluster rollout dần, hệ thống lúc tốt lúc xấu outage dao động khiến ban đầu bị nhầm là DDoS.
Bước tiếp theo
Cả hai dạng Shared fate kể trên đều có chung một dấu hiệu nhận biết: tồn tại một shared logic nằm ngoài phạm vi cô lập của từng AZ.
Việc bạn có thể làm ngay lúc này là mở sơ đồ kiến trúc của hệ thống đang vận hành và đánh dấu đỏ toàn bộ các thành phần duy nhất cấp Region/Tài khoản - bao gồm bản ghi DNS, centralized config store, hay các automation process có quyền ghi diện rộng. Mỗi dấu là một điểm thể hiện số vùng khả dụng không có ý nghĩa.
Shared fate mới chỉ là một phần của bức tranh. Còn 3 dạng Failure mode khác mà mô hình Multi-AZ không thể tự bảo vệ:
Đường khôi phục đi qua đúng thành phần đang sụp đổ (Recovery dependency).
Trạng thái nghẽn kéo dài dù nguyên nhân gốc đã xử lý xong (Metastable failure).
Lỗi ngầm khiến người dùng chịu trận nhưng giám sát vẫn "xanh" (Gray failure).
Phần 2 đi sâu phân tích 3 dạng này.
Nguyễn Phúc LộcPhó Giám Đốc Trung Tâm Phát Triển Dịch Vụ Hạ Tầng Cloud
Kiến trúc bảo mật cloud trước tốc độ viết code của AI: gom tín hiệu rời rạc thành bản đồ đường tấn công
10:44 07/09/2026
AI đang viết một tỷ lệ ngày càng lớn lượng code mới của thế giới với tốc độ nhanh hơn mọi quy trình security review truyền thống có thể theo kịp. Phần lớn doanh nghiệp không thiếu công cụ bảo mật mà họ thiếu context: khả năng ghép hàng trăm cảnh báo rời rạc thành đường tấn công, cho thấy kẻ tấn công sẽ đi từ đâu đến đâu. Bài viết phân tích vì sao tốc độ của AI buộc bảo mật phải thay đổi ở tầng kiến trúc thay vì bổ sung công cụ, và cách chúng tôi giải bài toán đó với FPT Cloud Security Platform.
AI làm code nhanh hơn, lỗ hổng bảo mật cũng nhiều hơn
75% dòng code mới tại Google hiện do AI tạo ra, theo công bố của CEO Alphabet Sundar Pichai. Kevin Scott, CTO Microsoft dự báo con số này tiến tới 95% trong 5 năm tới. GenAI đang dẫn đầu tăng trưởng trong các dịch vụ public cloud: mức sử dụng tăng 8 điểm phần trăm (percentage point) lên 58%, với 45% tổ chức đã triển khai ở quy mô lớn (Flexera, 2026 State of the Cloud Report). Gartner nhận định tới năm 2028, điện toán đám mây chuyển từ vai trò công nghệ đột phá thành cấu phần bắt buộc của năng lực cạnh tranh. Tại Việt Nam, thị trường cloud được dự báo đạt 6,98 tỷ USD vào năm 2030, CAGR 10,94% (TechSci Research). Cloud đã không còn chỉ là nơi đặt máy chủ mà trở thành nền tảng nơi phần mềm và AI được tạo ra, triển khai và vận hành.
Khoảng cách giữa tốc độ phát triển và tốc độ bảo mật ngày càng lớn
Cái giá của những dòng “code nhanh” từ AI không nằm ở màn hình người viết. 61% kỹ sư đánh giá code do AI tạo "trông đúng nhưng chưa chắc đáng tin" (Sonar, State of Code Developer Survey 2026).
Veracode, trong GenAI Code Security Report 2025, đo tỷ lệ code do AI sinh ra không vượt qua kiểm tra bảo mật theo từng ngôn ngữ:
Ngôn ngữ
Tỷ lệ code AI-generated không vượt qua kiểm tra bảo mật
Java
72%
C#
45%
JavaScript
43%
Python
38%
Nguồn: Veracode, 2025 GenAI Code Security Report
Đây không phải bài toán riêng của doanh nghiệp dùng AI viết phần mềm. Code do AI tạo đang chảy vào mọi hệ thống qua thư viện mã nguồn mở, đối tác gia công và nhà cung cấp phần mềm. Ở chiều ngược lại, tin tặc dùng AI để dò lỗ hổng và tự động hóa khai thác. 94% lãnh đạo trong khảo sát của Diễn đàn Kinh tế Thế giới coi AI là động lực thay đổi lớn nhất của an ninh mạng (WEF Global Cybersecurity Outlook 2026).
6 “điểm đau” bảo mật doanh nghiệp thường mắc phải
security tham gia quá muộn, lỗi chỉ được phát hiện sau khi release;
mỗi giai đoạn phát triển dùng một công cụ riêng, không chia sẻ dữ liệu;
nhiều dashboard nhưng không có bức tranh tổng thể;
đội vận hành ngập trong cảnh báo tới mức chai lì (alert fatigue);
báo động giả (false positive) bào mòn niềm tin vào chính công cụ;
và khi mọi cảnh báo đều "đỏ", không còn gì thực sự quan trọng.
Hầu hết tổ chức tập trung phòng thủ luồng North-South - traffic ra vào giữa Internet và hệ thống nội bộ, nơi dễ nhận diện và chặn bằng gateway hay WAF. Luồng East-West - giao tiếp giữa các server, ứng dụng và database - chiếm khoảng 70-80% tổng traffic nhưng hiếm khi được kiểm soát tương xứng: thiếu microsegmentation và giám sát nội vùng, kẻ tấn công chỉ cần vượt qua perimeter một lần là di chuyển ngang (lateral movement) gần như tự do để tiếp cận dữ liệu.
Điểm mấu chốt: một quyền truy cập cấp quá rộng, một cổng dịch vụ mở, một lỗ hổng ứng dụng đứng riêng lẻ đều vô hại trong báo cáo của từng công cụ; ghép đúng trình tự, chúng là một đường tấn công (attack path) hoàn chỉnh. Không công cụ đơn lẻ nào nhìn thấy phép ghép đó, vì mỗi công cụ chỉ giữ một mảnh dữ liệu. Giới bảo mật gọi đây là bất đối xứng kinh điển, theo định đề của John Lambert (Microsoft Threat Intelligence): "Defenders think in lists. Attackers think in graphs. As long as this is true, attackers win."
FPT Cloud Security Platform: kết nối các dấu vết rời rạc, chỉ rõ đường tấn công
Nguyên tắc thiết kế của chúng tôi xuất phát từ chẩn đoán trên: nếu vấn đề là context, lời giải phải bắt đầu từ tầng dữ liệu, không phải từ việc bổ sung tính năng. Nền tảng được tổ chức thành ba tầng, theo thứ tự dữ liệu được xử lý.
Security Data Lake gom log tường lửa, sự kiện container, kết quả quét lỗ hổng và API call trên cloud về một nơi duy nhất, lưu trữ tại Việt Nam. Với CISO, điều này nghĩa là một giao diện duy nhất, thay vì gộp báo cáo thủ công từ nhiều tính năng bảo mật rời rạc.
Security Graph nối các tín hiệu trong data lake thành đường tấn công cụ thể - cho thấy nếu bị khai thác, kẻ tấn công sẽ đi từ đâu đến đâu. Đây là tầng trả lời câu hỏi ưu tiên: từ 500 cảnh báo không rõ mức độ, hệ thống lọc còn 5 lỗ hổng nằm trên đường tấn công khả thi dẫn tới tài sản quan trọng.
AI Security Engine làm việc trên cùng context đó với ba nhiệm vụ: AI Triage đọc context của từng phát hiện trước khi quyết định có báo động hay không, thay vì đẩy mọi phát hiện cho con người; AI Correlation nối tín hiệu từ code, runtime và cấu hình cloud để phát hiện những kiểu tấn công mà luật cố định (rule-based) bỏ sót; AI Remediation không dừng ở việc chỉ ra lỗi, mà đề xuất đoạn code cần sửa kèm lý do.
AI giảm tải chứ không thay quy trình. Dù tầng AI lọc được phần lớn nhiễu, luôn có một tỷ lệ phát hiện phải do con người phân tích và quyết định - thường là những ca khó nhất, nơi rủi ro kỹ thuật đan với bối cảnh nghiệp vụ. Tổ chức vẫn cần quy trình phản hồi, người chịu trách nhiệm và kỷ luật vá lỗi; nền tảng chỉ bảo đảm thời gian của đội ngũ dồn vào đúng phần đáng dồn
Lộ trình từ Code -> Security Platform
AppSec chạy song song sáu lớp quét - SAST, secret scan, IaC scan, container image scan, DAST API scan - tích hợp thẳng vào CI/CD theo hướng shift-left. Khác biệt nằm ở pipeline suy luận sâu: source code được phân tích qua AST, data flow, taint analysis, rồi tới bước AI reasoning chạy trên FPT AI Factory để đưa ra kết luận theo context (context-aware verdict). Kết quả từ tất cả các lớp đổ về một correlation engine, xếp hạng rủi ro theo khả năng khai thác (exploitability), phạm vi ảnh hưởng (blast radius) và tác động kinh doanh - hiển thị trên một dashboard chung cho Dev, Sec và Ops. Cách gom mọi rủi ro về một đồ thị phân tích duy nhất cắt 80-90% cảnh báo rác.
Auto-triage là một cơ chế suppression, và mọi cơ chế suppression đều có xác suất nén nhầm một phát hiện thật. Đổi lấy việc cắt 80-90% cảnh báo rác là rủi ro false negative, và rủi ro đó phải được quản trị bằng thiết kế chứ không bằng niềm tin vào mô hình. Ba nguyên tắc chúng tôi áp dụng: chỉ tự động đóng khi mức tin cậy vượt ngưỡng đặt trước, dưới ngưỡng thì hạ mức ưu tiên chứ không tắt cảnh báo; một số lớp không bao giờ được tự động đóng, gồm secret bị lộ, lỗ hổng trên bề mặt hướng Internet và tài sản thuộc nhóm quan trọng nhất; và mọi quyết định suppress đều lưu lại tín hiệu cùng lý do dẫn tới nó để truy vết ngược khi cần. Đi kèm là một chỉ số vận hành ít được nhắc nhưng quan trọng nhất với tầng này: tỷ lệ phát hiện từng bị nén rồi sau đó được xác nhận là thật. Nếu con số ấy không được đo, không thể khẳng định cơ chế đang chạy đúng.
Với các tổ chức thuộc phạm vi điều chỉnh của quy định trong nước, nền tảng tự động phát hiện sai lệch cấu hình và xuất báo cáo làm bằng chứng tuân thủ khi kiểm tra, đánh giá định kỳ. Từ 01/7/2026, Luật An ninh mạng số 116/2025/QH15 hợp nhất và thay thế Luật An toàn thông tin mạng 2015 cùng Luật An ninh mạng 2018; cơ chế bảo vệ theo 5 cấp độ nay được chi tiết hóa tại Nghị định 331/2026/NĐ-CP (19/8/2026) — văn bản thay vai trò của Nghị định 85/2016/NĐ-CP và Thông tư 12/2022/TT-BTTTT, bổ sung yêu cầu đánh giá rủi ro, rà quét lỗ hổng và kiểm thử xâm nhập. Hệ thống đã phê duyệt cấp độ theo luật cũ phải cập nhật biện pháp bảo vệ trong 12 tháng kể từ ngày Luật có hiệu lực; ở phía ngân sách, Điều 38 yêu cầu dành tối thiểu 15% kinh phí dự án chuyển đổi số dùng ngân sách nhà nước cho an ninh mạng.
Hợp nhất context đồng nghĩa với tập trung dữ liệu bảo mật - và kho dữ liệu ấy tự nó là mục tiêu giá trị cao. Log bảo mật thường chứa cả secret bị lộ lẫn dữ liệu cá nhân, nên đi kèm nó phải là phân quyền theo least privilege, mã hóa khi lưu và khi truyền, quản lý khóa tách biệt, audit log truy cập, cùng chính sách retention và masking - thiết kế từ đầu, không bổ sung sau. Đây là nghĩa vụ pháp lý: Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 và Nghị định 356/2025/NĐ-CP (hiệu lực 01/01/2026, thay Nghị định 13/2023) buộc lập hồ sơ DPIA và đánh giá tác động chuyển dữ liệu ra nước ngoài trong 60 ngày, bố trí nhân sự bảo vệ dữ liệu, thông báo vi phạm trong 72 giờ với dữ liệu vị trí và sinh trắc học. Mức phạt tới 3 tỷ đồng, hoặc 5% doanh thu năm liền trước với vi phạm chuyển dữ liệu xuyên biên giới, chi tiết tại Nghị định 330/2026/NĐ-CP (hiệu lực 05/10/2026). Data lake đặt tại Việt Nam đáp ứng yêu cầu vị trí lưu trữ theo Điều 19 Nghị định 333/2026/NĐ-CP (thay Nghị định 53/2022) và sàn retention nhật ký tối thiểu 12 tháng; nếu dữ liệu chạm ngưỡng "quan trọng"/"cốt lõi" theo Quyết định 20/2025/QĐ-TTg thì áp thêm nghĩa vụ đánh giá rủi ro hằng năm của Luật Dữ liệu 60/2024/QH15 và Nghị định 165/2025/NĐ-CP.
Nội dung bài viết là thông tin kỹ thuật, không phải tư vấn pháp lý.
Tác Giả: Bùi Song Toàn
Bùi Song Toàn là Phó Giám đốc Trung tâm Phát triển dịch vụ Nền tảng Cloud, FPT Smart Cloud, với hơn 10 năm kinh nghiệm trong hạ tầng CNTT và platform engineering. Ông phụ trách phát triển lớp dịch vụ nền tảng trên FPT Cloud: Kubernetes và container platform, CI/CD cùng các dịch vụ platform engineering, data platform, observability, hạ tầng phục vụ AI, và nhóm dịch vụ bảo mật nền tảng - trong đó có FPT Cloud Security Platform và FPT AppSec.
[Phần 1] Tương lai của CyberSecurity: Từ Morris Worm đến AI Agent – Sự cố tiếp theo bắt nguồn từ đâu?
10:50 27/08/2026
Nhìn lại lịch sử cybersecurity, phần lớn những năng lực phòng thủ mà chúng ta đang coi là tiêu chuẩn hôm nay đều được hình thành sau một sự cố. Từ Morris Worm, Code Red, Pegasus đến Capital One, mỗi sự cố đều tạo ra một bước chuyển trong cách ngành nhìn nhận và quản trị rủi ro. Khi AI đang thay đổi cách hệ thống vận hành, câu hỏi đặt ra là: điểm bùng phát rủi ro tiếp theo sẽ nằm ở đâu?
Có một cách để ta nhìn lại lịch sử ngành Cybersecurity: Đừng bắt đầu từ danh mục sản phẩm bảo mật. Hãy bắt đầu từ những lần chúng ta gặp sự cố. Mọi thứ chúng ta đang dùng hôm nay - từ quy trình, framework cho đến cả những chức danh trong team - đều không xuất hiện từ một bản kế hoạch nào cả. Chúng xuất hiện sau một sự cố, khi ai đó nhận ra rằng thứ mình đang có không còn đủ.
Bốn mốc dưới đây không phải bốn vụ tấn công lớn nhất trong lịch sử. Chúng được lựa chọn vì mỗi mốc đánh dấu một lần ngành này buộc phải thừa nhận rằng mô hình phòng thủ đang sử dụng không còn phù hợp với hệ thống hiện đang vận hành.
1. 1988 - Morris Worm: Khi sự cố đầu tiên khai sinh ra Incident Response
Ngày 2/11/1988, Internet là một không gian hoàn toàn sơ khai, chủ yếu kết nối các viện nghiên cứu, trường đại học và cơ quan chính phủ với quy mô chừng 60.000 máy tính. Khái niệm an ninh mạng lúc bấy giờ còn đơn giản là chưa tồn tại.
Robert Tappan Morris, một nghiên cứu sinh tại Đại học Cornell, đã phát tán một chương trình tự nhân bản từ một máy đặt tại MIT để che giấu nguồn gốc. Chương trình này khai thác đồng thời ba điểm yếu kinh điển trên hệ thống Unix thời đó:
sendmail: Phần mềm nhận email vốn bật sẵn chế độ debug cho phép chạy lệnh từ xa.
fingerd: Dịch vụ tra cứu thông tin người dùng mắc lỗi tràn bộ đệm (buffer overflow).
rsh: Cơ chế đăng nhập từ xa dựa trên quan hệ tin cậy giữa các máy kèm mật khẩu yếu.
Sự lây lan chóng mặt của worm xuất phát từ thiết kế đa đường vào: nếu một cổng bị chặn, mã độc vẫn còn hai hướng khác để xâm nhập. Tuy nhiên, thảm họa thực sự lại đến từ một lỗi logic trong thuật toán kiểm soát tái nhiễm. Tỷ lệ tự sao chép bị tính toán sai khiến một máy tính có thể cộng dồn hàng chục bản sao cùng lúc, làm cạn kiệt toàn bộ tài nguyên CPU và bộ nhớ rồi làm tê liệt hệ thống. Ước tính khoảng 6.000 máy bị ảnh hưởng - chiếm khoảng 10% quy mô Internet khi đó.
Thứ lộ ra sau đống tro tàn ấy còn đáng sợ hơn cả con số 10%: hoàn toàn không có một đầu mối trung tâm nào đứng ra điều phối ứng cứu. Mỗi tổ chức phải tự mày mò dịch ngược mã độc, tự vá lỗi và truyền tay nhau qua các mailing list thủ công. Mọi thứ vận hành được chỉ nhờ sự kết nối tự phát của vài chục chuyên gia tình cờ quen biết.
Nhận ra khoảng trống tai hại này, DARPA đã giao cho Viện Kỹ thuật Phần mềm (SEI) tại Đại học Carnegie Mellon xây dựng một đầu mối chuyên trách. CERT/CC (Computer Emergency Response Team / Coordination Center) ra đời ngay trong tháng 11/1988. Phần lớn khung pháp lý và quy trình Phản ứng Sự cố (Incident Response) mà chúng ta đang sử dụng ngày nay được sinh ra từ chính cuộc khủng hoảng không được chuẩn bị trước đó.
2. 2001 - Code Red: Khoảng trễ vá lỗi (Patch Gap) là một dạng rủi ro hệ thống
Mười ba năm sau, lịch sử lặp lại với một hình thái tinh vi hơn và quy mô lớn hơn gấp nhiều lần.
Ngày 18/6/2001, Microsoft phát hành bản vá MS01-033 để xử lý lỗ hổng tràn bộ đệm trong Index Server (CVE-2001-0500) trên máy chủ web IIS. Lỗ hổng này sau đó được định danh là CVE-2001-0500 .Điểm quan trọng là bản vá đã tồn tại trước khi cuộc tấn công xảy ra. Khoảng trống nằm ở việc triển khai bản vá.
Đến ngày 19/7/2001, biến thể Code Red version 2 (CRv2) bùng nổ sau khi thay đổi cơ chế sinh số ngẫu nhiên từ dạng tĩnh sang dạng động. Thay vì quét cùng một dải IP khiến các con worm tự giẫm chân nhau, mỗi máy nhiễm giờ đây tự quét một danh sách độc lập. Thay đổi nhỏ đó đẩy tốc độ lây nhiễm lên mức kỷ lục: hơn 359.000 máy tính bị hạ gục chỉ trong chưa đầy 14 giờ, với đỉnh điểm ghi nhận hơn 2.000 host mới mỗi phút (theo số liệu từ CAIDA).
Một điểm cần phân biệt là Code Red II là một worm khác, xuất hiện ngày 4/8/2001. Nó sử dụng cùng vector khai thác với Code Red nhưng có payload khác, cài backdoor và ưu tiên lây lan sang các máy trong cùng subnet.
Morris Worm cho thấy một chương trình tự sao chép có thể gây gián đoạn trên Internet. Code Red đưa vấn đề lên một cấp độ khác: khi hệ thống đã đủ lớn, khoảng trễ giữa “đã có bản vá” và “đã triển khai bản vá” có thể trở thành một rủi ro ở quy mô toàn hệ thống.
Patch gap từ đó không còn đơn thuần là một vấn đề vận hành nội bộ. Nó trở thành một yếu tố rủi ro có thể đo lường và có thể trực tiếp quyết định tốc độ lan rộng của một cuộc tấn công. Từ đây, Quản trị lỗ hổng (Vulnerability Management), Quy trình Patching chuẩn hóa và hệ thống IDS/IPS chính thức trở thành yêu cầu sống còn của mọi hệ thống kết nối mạng.
3. 2016 - Pegasus và Ahmed Mansoor: Khi "Endpoint" có thể là một con người
Tháng 8/2016, nhà hoạt động nhân quyền Ahmed Mansoor nhận được tin nhắn SMS lạ chứa liên kết hứa hẹn hé lộ thông tin về những vụ tra tấn trong tù. Cảnh giác trước cạm bẫy, ông không truy cập đường link mà chuyển tiếp tin nhắn cho Citizen Lab - nhóm nghiên cứu tại Munk School, tại Đại học Toronto, chuyên điều tra việc sử dụng phần mềm gián điệp nhắm vào các nhà hoạt động và nhà báo.
Bên dưới đường link đó là Trident - chuỗi 3 lỗ hổng zero-day trên iOS:
CVE-2016-4657: Lỗi bộ nhớ trong WebKit mở đường đột nhập khi mở trang web.
CVE-2016-4655: Lỗi rò rỉ thông tin kernel, được sử dụng để vượt qua KASLR
CVE-2016-4656: Lỗi trong kernal cho phép thực thi mã độc, tiến hành jailbreak thiết bị hoàn toàn từ xa.
Chuỗi khai thác này kích hoạt phần mềm gián điệp Pegasus do NSO Group phát triển. Điểm chấn động của sự cố không nằm ở kỹ thuật tấn công ồn ào, mà ở sự dịch chuyển toàn diện của mô hình mục tiêu: không có worm quét hàng trăm nghìn server, không cần người dùng cài đặt một phần mềm lạ hay nhập mật khẩu, không có lượng traffic bất thường đủ lớn để dễ dàng bị phát hiện bởi các hệ thống giám sát truyền thống. Một chuỗi khai thác có giá trị thị trường lên tới hàng trăm nghìn đến khoảng một triệu USD được sử dụng để nhắm vào đúng một chiếc điện thoại của một cá nhân duy nhất.
Định nghĩa "Endpoint" từ mốc này đã thay đổi vĩnh viễn. Nó không còn là một thiết bị nằm trong danh sách tài sản cần bảo vệ. Nó có thể là một cá nhân cụ thể, và mức độ đầu tư của kẻ tấn công có thể được quyết định bởi giá trị của chính mục tiêu đó.
4. 2019 - Capital One: Cloud không có lỗi, lỗi ở cấu hình
Ngày 22 và 23/3/2019, dữ liệu của ngân hàng Capital One bị truy cập trái phép.
Sự cố không được phát hiện trong khoảng bốn tháng. Đến ngày 17/7/2019, một người dùng GitHub phát hiện bài đăng của kẻ tấn công về dữ liệu đã lấy được và báo cho Capital One thông qua chương trình Responsible Disclosure. Ngày 19/7, sau điều tra nội bộ, Capital One xác định đã có truy cập trái phép và thông báo cho FBI. Sự việc được công bố ra công chúng ngày 29/7
Khoảng 100 triệu người tại Mỹ và 6 triệu người tại Canada bị ảnh hưởng. Không có số thẻ tín dụng hay thông tin đăng nhập bị lộ.
Điểm đáng chú ý nằm ở chuỗi tấn công. Theo hồ sơ của Bộ Tư pháp Mỹ và các phân tích sau đó, cuộc tấn công gồm bốn bước:
Một tường lửa ứng dụng web (WAF) bị cấu hình sai, cho phép khai thác SSRF (Server-Side Request Forgery) - kiểu tấn công lừa máy chủ tự đứng ra gửi request thay mình, qua đó, chạm được vào những địa chỉ nội bộ mà từ bên ngoài không gọi tới được.
Máy chủ chạy WAF được gán một IAM role có phạm vi quyền rộng hơn mức cần thiết.
Kẻ tấn công dùng SSRF truy cập vào EC2 Metadata Service - một địa chỉ nội bộ mà mọi máy ảo trên AWS đều truy cập được để đánh cắp credential tạm thời của IAM Role.
Bộ Credential này có đủ quyền để liệt kê và đọc dữ liệu trong S3, dịch vụ lưu trữ object của AWS.
Điều đáng chú ý là không có zero-day và cũng không có thành phần Cloud nào tự thân bị lỗi. Các thành phần đều hoạt động theo đúng cách chúng được cấu hình.
Khoảng trống nằm ở mối quan hệ giữa chúng: một cấu hình sai ở lớp ứng dụng, kết hợp với một IAM Role được cấp quyền rộng tay là đủ để biến kiến trúc đó thành cửa ngõ tới toàn bộ dữ liệu phía sau. Đây cũng là lúc Cloud Security, IAM, Configuration Management, CSPM và Shared Responsibility Model chuyển từ những khái niệm mang tính lý thuyết thành các năng lực phải được đưa vào vận hành thực tế.
5. Điểm bùng phát tiếp theo: AI đang đứng ở đâu trong chu kỳ lịch sử?
Nhìn dọc theo chuỗi 4 thập kỷ, một quy luật ngầm lộ diện rõ ràng: Mỗi khi một làn sóng công nghệ mới đạt đến quy mô đại trà, ngành an ninh mạng luôn trải qua một khoảng trễ quản trị và khoảng trễ đó thường khép lại bằng một cuộc khủng hoảng hệ thống.
Sau mỗi sự cố, ngành Cybersecurity lại được bổ sung thêm những lớp năng lực phòng thủ mới: sản phẩm, quy trình, framework và regulation. Quan trọng hơn, mỗi lần như vậy lại mở ra một cách nhìn mới về Risk.
Làn sóng AI hiện tại đang đứng ngay ranh giới của điểm bùng phát đó. Điểm khác biệt là các rủi ro mới không xuất hiện dưới dạng một mã độc phá hoại phần cứng, mà nằm ở sự đứt gãy kiến trúc vận hành:
Prompt Injection: Việc chèn lệnh độc hại trực tiếp vào luồng dữ liệu đầu vào khiến mô hình nhầm lẫn giữa dữ liệu và mệnh lệnh. Chúng ta đang loay hoay xử lý bằng filter và guardrail, giống hệt cách ngành CNTT từng chắp vá để chặn SQL Injection trước khi có chuẩn hóa Prepared Statement.
AI Agent tự trị: Các AI Agent đang được trao quyền thực thi và truy cập dữ liệu ở tốc độ machine-speed, lặp lại chính xác sai lầm cấp quyền lỏng lẻo của sự cố Capital One, nhưng ở cấp độ tự chủ cao hơn rất nhiều.
Ranh giới tin cậy giữa dữ liệu và chỉ thị: Mọi kiến trúc CNTT trước đây đều tách biệt được hai luồng này - code đi một đường, data đi một đường. Với các mô hình LLM, cả hai lại đi chung trên cùng một kênh. Đây là bản chất và đặc tính cốt lõi của mô hình chứ không phải một lỗi kỹ thuật chờ được vá.
6. Rủi ro không đến từ một cuộc tấn công và 5 chốt kiểm soát doanh nghiệp cần kiểm tra
Capital One vẫn cần một kẻ tấn công thực sự bước qua khe hở cấu hình. Nhưng với AI Agent, hệ thống có thể tự sụp đổ mà không cần bất kỳ tác nhân độc hại nào từ bên ngoài. Một agent chạy ở tốc độ máy có thể làm đúng chính xác những gì được cấu hình nhưng vẫn tự động duyệt nhầm hàng loạt khoản hoàn tiền, gửi sai danh sách khách hàng nhạy cảm, hay đưa ra một kết quả (output) sai lệch để làm đầu vào cho một quyết định chiến lược. Không ai xâm nhập, các công cụ giám sát hoàn toàn mù tịt vì không có bất kỳ dấu vết nào trông giống một cuộc tấn công.
Phần lớn các cuộc thảo luận về AI governance hiện nay đều được thiết kế quanh việc ngăn một vụ rò rỉ dữ liệu. Với bối cảnh này thì đó là hình dạng sai. Để không lặp lại sai lầm của các thế hệ đi trước, doanh nghiệp cần rà soát ngay 5 chốt kiểm soát cốt lõi:
Agent identity. Agent có danh tính riêng, hay đang mượn danh tính của một con người? (2016: endpoint trở thành một con người. Giờ con người đó là một service account.)
Permission boundary. Quyền theo phạm vi, có thời hạn, tối thiểu, cấp theo tác vụ chứ không theo cả hệ thống. (Capital One, bước 2.)
Human-in-the-loop. Xác định hành động nào tuyệt đối không được tự động. Thanh toán, thay đổi trên production, xuất dữ liệu, mọi thứ có đối tác bên ngoài tham gia. (Capital One, bước 4.)
Observability. Bạn có dựng lại được vì sao agent làm việc đó không, ở dạng mà auditor chấp nhận? (Capital One: bốn tháng không ai biết.)
Kill và rollback. Bạn có dừng được toàn bộ agent bằng một thao tác, và đảo ngược được thứ chúng đã làm không? (1988: không ai điều phối nổi việc phản ứng.)
Có thể vài năm nữa, giai đoạn 2022-2023 sẽ được nhìn lại theo cách ngành Cybersecurity nhìn về năm 1988. Không phải vì đó là thời điểm AI trở nên nguy hiểm. Mà vì thế, đó có thể là thời điểm ngành nhận ra rằng mô hình phòng thủ cũ đã không còn đủ cho một hệ thống mới.
Tác giả: Lê Ngọc Linh - Leader of Platform Security Engineers, FPT Smart Cloud
Liên hệ với chúng tôi để được tư vấn chi tiết về các giải pháp, dịch vụ của FPT Cloud:
Hotline: 1800 6139
Email: support@fptcloud.com
Support: m.me/fptsmartcloud
AI có thể viết code đúng nhưng chưa chắc đáng tin
15:17 25/08/2026
Theo khảo sát “State of Code Developer Survey 2026”, 61% kỹ sư phần mềm đánh giá code do AI viết "có thể đúng, nhưng chưa chắc đã đáng tin".
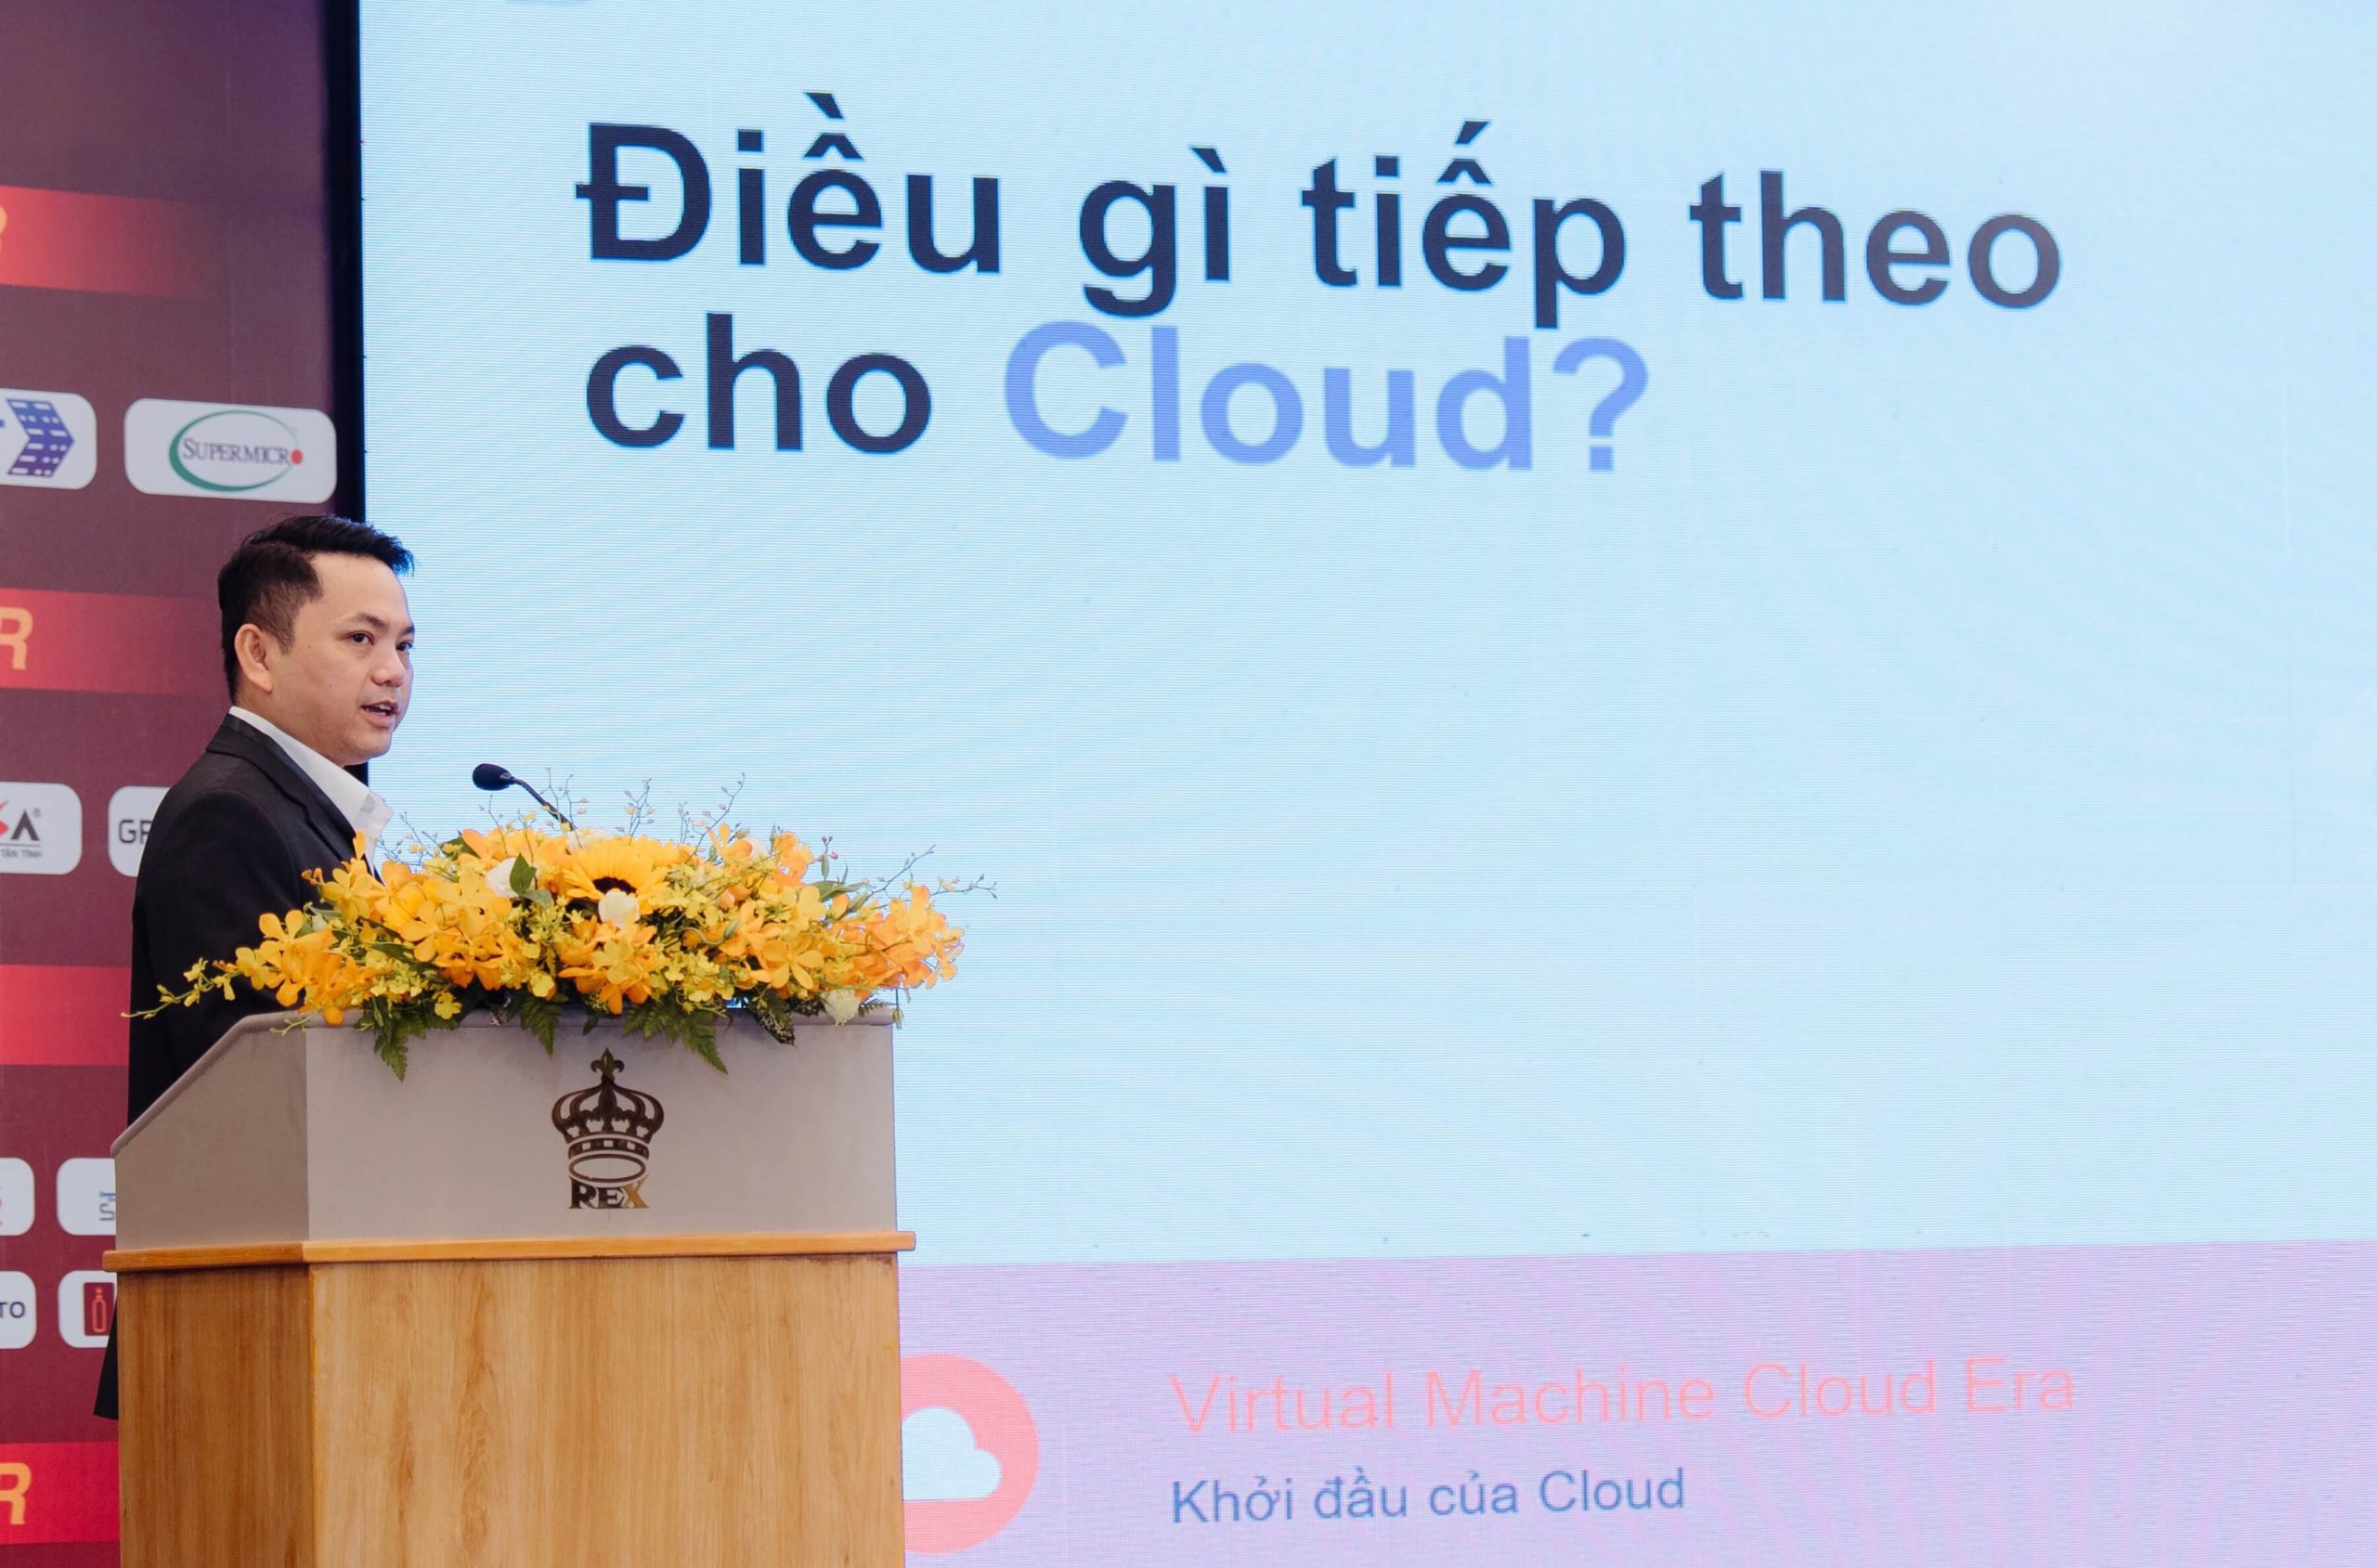
Thông tin trên được ông Bùi Song Toàn, Phó Giám đốc Trung tâm Phát triển dịch vụ Nền tảng Cloud, FPT Smart Cloud, Tâp đoàn FPT đã đưa ra tại hội nghị GrowthVerse Cloud Day 2026 với chủ đề: "Tăng trưởng về điện toán đám mây và trí tuệ nhân tạo” được tổ chức tại TPHCM vào ngày 14/8 vừa qua.
Ông Toàn cho biết, khảo sát toàn cầu của Flexera cho thấy 45% tổ chức đã triển khai GenAI ở quy mô lớn. Theo công bố của CEO Alphabet Sundar Pichai, 75% dòng code mới tại Google hiện do AI tạo ra; còn CTO Microsoft Kevin Scott dự báo tỷ lệ này sẽ tiến tới 95% trong vòng 5 năm tới.
Theo ông Toàn, AI đang giúp doanh nghiệp tạo ra phần mềm nhanh chưa từng có, nhưng cũng khiến khoảng cách giữa tốc độ phát triển và năng lực bảo mật ngày càng lớn, đi kèm đó là nhiều rủi ro bảo mật hơn.
Cụ thể về chất lượng bảo mật của code do AI sinh ra, báo cáo GenAI Code Security 2025 của Veracode cho thấy, hơn 70% code Java do AI tạo không vượt qua kiểm tra bảo mật; với C#, JavaScript và Python, tỷ lệ này lần lượt là 45%, 43% và 38%.
Theo khảo sát “State of Code Developer Survey 2026”, 61% kỹ sư phần mềm đánh giá code do AI viết "có thể đúng, nhưng chưa chắc đã đáng tin".
Ông Toàn phân tích, đây không phải bài toán riêng của doanh nghiệp dùng AI để viết phần mềm. Code do AI tạo ra đang chảy vào mọi hệ thống qua thư viện mã nguồn mở, đối tác gia công và nhà cung cấp phần mềm. Ở chiều ngược lại, tin tặc cũng dùng AI để dò lỗ hổng và tự động hóa tấn công. 94% lãnh đạo trong khảo sát của Diễn đàn Kinh tế Thế giới (WEF) coi AI là động lực thay đổi lớn nhất của an ninh mạng.
Ông Bùi Song Toàn, Phó Giám đốc Trung tâm Phát triển dịch vụ Nền tảng Cloud, FPT Smart Cloud, Tâp đoàn - phát biểu tại sự kiện GrowthVerse Cloud Day 2026
Hiện nay, đã có nhiều doanh nghiệp coi điện toán đám mây là yếu tố bắt buộc trong chiến lược kinh doanh và trí tuệ nhân tạo tạo sinh (GenAI) trở thành động lực thúc đẩy chính. Việt Nam cũng không đứng ngoài cuộc, khi thị trường điện toán đám mây trong nước được dự báo đạt 6,98 tỷ USD vào năm 2030 với tốc độ tăng trưởng gần 11% mỗi năm.
Và khi các rủi ro bảo mật mới xảy ra, phản xạ phổ biến của doanh nghiệp là đầu tư thêm công cụ bảo mật.
Từ kinh nghiệm vận hành nền tảng cloud cho khối doanh nghiệp, đại diện FPT Smart Cloud chỉ ra sáu điểm "đau" lặp lại ở hầu hết tổ chức: lỗi bảo mật chỉ được phát hiện sau khi sản phẩm đã phát hành; mỗi khâu dùng một công cụ riêng không chia sẻ dữ liệu; quá nhiều màn hình báo cáo nhưng không có bức tranh tổng thể; đội vận hành "chai lì" vì ngập trong cảnh báo; báo động giả làm mất niềm tin; và khi mọi cảnh báo đều đỏ, không còn gì thực sự quan trọng.
Để giải quyết bài toán này, theo ông Toàn phải bắt đầu từ nơi rủi ro sinh ra: những dòng code. Theo ông, bước khởi đầu chi phí thấp nhất là rà soát bảo mật ngay từ khâu phát triển phần mềm, trước khi mở rộng dần sang các lớp hạ tầng, dữ liệu và định danh khác.
Theo báo Vietnamnet.vn
[Phần 2] Tương lai của CyberSecurity: AI và bức tranh An ninh mạng: Khi quản trị rủi ro phải chạy đua cùng công nghệ
10:29 10/08/2026
Việc AI đang tái định hình bức tranh an ninh mạng là điều không thể phủ nhận. Tuy nhiên, câu hỏi chiến lược không còn là "AI có tạo ra sự thay đổi hay không?", mà là: Chúng ta đang ở chu kỳ nào của làn sóng này và doanh nghiệp còn bao nhiêu thời gian để thiết lập cơ chế phòng thủ trước khi một cuộc khủng hoảng thực sự nổ ra?
Theo WEF Global Cybersecurity Outlook 2026, 94% lãnh đạo an ninh mạng nhận định AI là động lực biến đổi lớn nhất của ngành trong năm tới. Để hiểu rõ cục diện, chúng ta cần nhìn vào 5 khía cạnh cốt lõi sau:
1. Chu kỳ công nghệ: Doanh nghiệp đang đứng đâu trên đường cong rủi ro?
Nhìn lại lịch sử từ PC, Internet, Mobile đến Cloud, mỗi làn sóng công nghệ đều vận hành qua một framework 4 giai đoạn:
Ngạc nhiên: Công nghệ mới ra đời và được đón nhận.
Lạm dụng: Giai đoạn các tác nhân độc hại bắt đầu khai thác lỗ hổng (điển hình như virus DOS thời kỳ PC, web defacement thời Internet, mã độc mobile thời di động, hay rò rỉ cấu hình S3 trong kỷ nguyên Cloud).
Khủng hoảng: Một sự cố mang tính hệ thống buộc toàn ngành phải nhìn lại (Morris Worm 1988, Pegasus 2016).
Trưởng thành: Chuẩn hóa quản trị và hệ sinh thái phòng thủ chuyên biệt hình thành.
AI hiện đang nằm giữa ranh giới của giai đoạn Lạm dụng và Khủng hoảng, với các biểu hiện rõ nét thông qua prompt injection hay deepfake. Dựa trên các bài học từ những chu kỳ phát triển công nghệ trước đây, các sự cố quy mô lớn trong tương lai có thể trở thành động lực thúc đẩy doanh nghiệp và toàn ngành tăng cường chuẩn hóa quản trị AI, đặc biệt trong giai đoạn 2026-2027.
Từ việc quan sát các chu kỳ công nghệ trước đây, có thể đúc kết hai quy luật ngầm đang trực tiếp chi phối làn sóng AI hiện tại. Trước hết, công nghệ luôn bứt phá đi trước, trong khi chuẩn hóa và kiểm soát luôn phải chạy theo sau. Theo báo cáo WEF 2026, tỷ lệ tổ chức chủ động đánh giá an toàn AI trước khi triển khai đã tăng mạnh từ 37% lên 64% chỉ trong một năm, một tín hiệu cho thấy công tác quản trị đang ráo riết chạy đua để bắt kịp, nhưng trên thực tế, nó vẫn đang ở thế bị động và đi sau công nghệ.
Thứ hai, công nghệ tạo đà tăng trưởng nhanh, nhưng quản trị tốt mới là nền tảng để đi đường dài. Các tổ chức có mức độ trưởng thành số cao nhất đang xếp rủi ro AI là mối đe dọa số 1. Điều này cho thấy: Tổ chức càng hiểu và ứng dụng AI sâu, họ càng nhìn rõ rủi ro để chủ động kiểm soát, thay vì giữ tâm lý chủ quan.
2. Sự sụp đổ của nguyên lý Bất đối xứng chi phí (Cost Asymmetry)
Tác động lớn nhất của AI không nằm ở việc sinh ra một loại mã độc mới, mà ở việc phá vỡ thế cân bằng chi phí giữa tấn công và phòng thủ vốn tồn tại hàng thập kỷ.
Trước đây, lợi thế luôn nghiêng về bên phòng thủ với nguồn lực dồi dào: ngân sách lớn, đội ngũ SOC đông đảo và hệ thống giải pháp đắt tiền. Ngày nay, một tác nhân đơn lẻ kết hợp cùng mạng lưới AI agents có thể vận hành một chiến dịch tấn công APT (Advanced Persistent Threat) tự động với chi phí biên gần như bằng 0.
Phép so sánh chân thực nhất chính là cách drone giá rẻ định hình lại chiến tranh hiện đại: một bầy drone nhỏ có thể vô hiệu hóa khí tài hàng triệu đô. AI đang mang mô hình tác chiến đó lên không gian mạng. Đó là lý do 87% tổ chức (theo WEF 2026) xác định: Lỗ hổng AI là rủi ro gia tăng nhanh nhất hiện nay.
3. Ba trụ cột rủi ro tái định hình kiến trúc bảo mật
Từ thực tiễn vận hành, có 3 rủi ro đang trực tiếp ép buộc các doanh nghiệp phải nâng cấp hệ thống phòng thủ:
Thứ 1, AI Model trở thành bề mặt tấn công mới. Model, prompt và training data đang đối mặt với các rủi ro chưa từng có: model poisoning, prompt injection, hay đánh cắp bản quyền. Đặc biệt, tình trạng rò rỉ dữ liệu qua "AI ngầm" (nhân viên tự ý sử dụng các công cụ AI ngoài tầm kiểm soát của doanh nghiệp) đang gây thiệt hại phát sinh khoảng 670.000 USD cho mỗi sự cố (theo IBM 2025). Tương tự như cách kỷ nguyên Điện toán đám mây sinh ra các tiêu chuẩn bảo mật mới, việc thiết lập hệ thống Quản trị trạng thái an ninh AI và truy vết nguồn gốc đang trở thành một hạng mục quản trị bắt buộc.
Thứ 2, Tốc độ vận hành ở ngưỡng Machine-speed. Các cuộc tấn công bằng AI có thể tự động biến hình liên tục theo thời gian thực, khiến đội ngũ vận hành bị quá tải vì cảnh báo. Giải pháp là chuyển từ hệ thống tĩnh (chặn theo dấu hiệu có sẵn) sang hệ thống động: dùng AI phân tích hành vi để phản ứng tức thời.
Thứ 3, Sự sụp đổ của định danh truyền thống. Kỹ thuật làm giả khuôn mặt/giọng nói (Deepfake) đang vô hiệu hóa các bước xác thực khách hàng (KYC) hiện tại. Gian lận AI đã trở thành mối đe dọa số 1 với các CEO (theo WEF 2026, 73% tổ chức từng bị ảnh hưởng). Trong mô hình bảo mật Zero Trust, câu hỏi lớn nhất không còn là "Bạn là ai?", mà phải là "Bạn có thực sự là con người không?". Một hệ quy chiếu mới về xác minh độ tin cậy và chứng minh "tính người" đang buộc phải hình thành.
4. Quy mô thị trường và khoảng trống quản trị
Thị trường an ninh mạng AI đang chứng kiến tốc độ tăng trưởng bùng nổ. Theo Grand View Research, quy mô toàn cầu dự kiến nhảy vọt từ 25,4 tỷ USD (2024) lên 93,8 tỷ USD vào năm 2030, tương đương mức tăng trưởng kép (CAGR) khoảng 24,4%. Dù các đơn vị nghiên cứu khác như Mordor hay Fortune Business Insights có sự chênh lệch nhất định về con số tuyệt đối do cách định nghĩa thị trường, tất cả đều đồng thuận mức tăng trưởng sẽ luôn duy trì trên mốc 20%/năm.
Tuy nhiên, đằng sau những con số tăng trưởng ấn tượng là một khoảng trống lớn về quản trị bởi tốc độ bứt phá của công nghệ đang bỏ xa các quy định pháp luật và bộ tiêu chuẩn an toàn. Báo cáo WEF 2026 chỉ ra rằng sự phức tạp trong quản trị an ninh AI (13%) và rủi ro pháp lý hay sở hữu trí tuệ (9%) đang là những "nỗi đau" lớn nhất của giới lãnh đạo. Thực trạng hiện nay là nhiều tổ chức vẫn thiếu vắng các tiêu chuẩn đánh giá AI cốt lõi, chưa phân định rõ người chịu trách nhiệm và sổ đăng ký rủi ro (risk register) hoàn toàn bỏ ngỏ hạng mục AI. Tuy nhiên, trước sức ép ngày càng lớn từ Nghị định 13/2023 về bảo vệ dữ liệu cá nhân hay Đạo luật AI của Châu Âu, các doanh nghiệp sẽ không thể lơ là mà bắt buộc phải đưa AI vào khuôn khổ kiểm soát chặt chẽ.
Một điểm mù cực kỳ nguy hiểm khác nhưng ít được chú ý là an ninh chuỗi cung ứng AI. Hiện nay, hầu hết doanh nghiệp không tự xây dựng AI từ đầu mà đi thuê hoặc dùng lại mô hình từ bên thứ ba. Điều này dẫn đến rủi ro "lây nhiễm chéo": nếu mô hình gốc bị hacker "đầu độc" bằng dữ liệu bẩn ở thượng nguồn, toàn bộ hệ thống của các công ty sử dụng ở hạ nguồn cũng sẽ bị nhiễm độc theo mà không hề hay biết. Thị trường hiện vẫn chưa có một loại "tem truy xuất nguồn gốc" (AI BOM) nào đủ phổ biến để người mua kiểm tra xem mô hình AI đó có thực sự toàn vẹn và an toàn hay không. Đó chính là lý do vì sao 78% các CEO ở những tổ chức có mức độ chuyển đổi số cao nhất (theo WEF 2026) đánh giá rủi ro từ đối tác cung cấp AI là thách thức lớn nhất mà họ đang phải đối mặt.
5. Ba vấn đề tổ chức cần cân nhắc trong 12–18 tháng tới
Giữa bối cảnh khoảng trống quản trị đang ngày càng nới rộng, việc dừng lại ở mức độ "nhận thức rủi ro" là không đủ. Nhìn lại toàn cảnh bức tranh, có ba dịch chuyển then chốt mà bất kỳ ai trong mạng lưới bảo mật từ kỹ sư vận hành đến đội ngũ C-level đều cần nghiêm túc đưa vào lộ trình ưu tiên trong 12-18 tháng tới:
Chủ động thu hẹp "độ trễ" phòng thủ: Thay vì chạy theo khắc phục sự cố, việc buộc phải kiểm tra rủi ro AI trước khi đưa vào vận hành chính là ranh giới phân định một doanh nghiệp thực sự trưởng thành số hay chỉ đang chạy theo trào lưu.
Thiết lập lại cán cân chi phí (Cost asymmetry): Sự bất đối xứng chi phí giữa tấn công và phòng thủ đã thay đổi hoàn toàn về bản chất. Các mô hình phòng thủ tĩnh, lệ thuộc vào ngân sách lớn đang dần lép vế trước các cá nhân tấn công được trang bị AI. Hệ thống bảo mật buộc phải chuyển đổi để đạt được tốc độ phản ứng tức thời (machine-speed).
Xoay trục kiến trúc định danh về "tính người": Định danh số và bài toán xác thực "tính người" (Proof-of-humanity) sẽ sớm phải tách ra thành một lớp bảo mật độc lập, vượt ra khỏi các khuôn khổ identity truyền thống.Đáng lo ngại là, đây lại là mảng bị bỏ ngỏ nhiều nhất tại các tổ chức hiện nay.
Những nhận định này hoàn toàn không phải là các dự báo mang tính thổi phồng, mà là chu kỳ phát triển tất yếu đã lặp lại nhiều lần trong lịch sử ngành an ninh mạng. Vấn đề cốt lõi không nằm ở việc liệu một cuộc khủng hoảng có xảy ra hay không, mà là: Tổ chức của bạn sẽ đứng ở đâu trên đường cong sinh tồn khi điểm bùng phát đó xuất hiện?
Nguồn dữ liệu tham khảo: WEF Global Cybersecurity Outlook 2026; Grand View Research – AI in Cybersecurity Market Report; IBM Cost of a Data Breach Report 2025.
Tác giả: Lê Ngọc Linh - Leader of Platform Security Engineers, FPT Cloud

Giải pháp AI tự phát triển của DNSE đưa công cụ giao dịch của tổ chức đến nhà đầu tư cá nhân
18:00 06/08/2026
Thị trường chứng khoán Việt Nam đang bước vào giai đoạn cạnh tranh mới, khi phí giao dịch hay chất lượng môi giới không còn là yếu tố quyết định. FTSE Russell đã xác nhận nâng hạng thị trường lên nhóm Mới nổi Thứ cấp, hiệu lực từ ngày 21/9/2026, Áp lực với các công ty chứng khoán chuyển sang năng lực hạ tầng số, khai thác dữ liệu và mức độ sẵn sàng đưa AI vào vận hành thực tế. Hệ giải pháp AI do Chứng khoán DNSE tự phát triển là một ví dụ cụ thể về việc AI đã đi vào giao dịch hàng ngày của nhà đầu tư như thế nào, và cần nền tảng gì để vận hành an toàn.
Tự chủ công nghệ để làm chủ trải nghiệm giao dịch
Thay vì mua giải pháp có sẵn từ bên thứ ba, DNSE chọn hướng tự chủ công nghệ. Toàn bộ nền tảng giao dịch và các sản phẩm AI đều do đội ngũ kỹ sư của công ty thiết kế, phát triển và vận hành. Hệ giải pháp gồm hai sản phẩm nhà đầu tư dùng trực tiếp, đứng trên một lớp nền tảng dữ liệu chung.
Lệnh AI là tính năng đặt lệnh ứng dụng mô hình AI trên ứng dụng giao dịch Entrade X. Khi nhà đầu tư cần mua hoặc bán khối lượng lớn, hệ thống liên tục thu thập và phân tích giá, khối lượng, biến động thị trường để xác định chiến lược phân bổ lệnh. AI sau đó tự động chia lệnh lớn thành các lệnh con, tối thiểu mỗi phút một lệnh, với khối lượng từng lệnh do mô hình quyết định. Thời gian chạy tối đa 180 phút trong phiên khớp lệnh liên tục. Lệnh con được tự động hủy nếu mô hình đánh giá điều kiện thị trường không còn phù hợp. Cơ chế này tương đồng với các thuật toán thực thi lệnh (execution algorithm) mà nhà đầu tư tổ chức quốc tế vẫn dùng để giảm tác động thị trường của lệnh lớn, nay được đóng gói cho nhà đầu tư cá nhân.
Trợ lý ảo Ensa là trợ lý chứng khoán ứng dụng AI dưới hình thức chatbot, hỗ trợ nhà đầu tư tra cứu và phân tích dữ liệu trong quá trình ra quyết định. Ensa từng được vinh danh "Giải pháp AI đột phá lĩnh vực tài chính" tại AI Awards 2024.
Bên dưới hai sản phẩm là hạ tầng do DNSE tự xây theo kiến trúc microservices, vận hành trên nền tảng điện toán đám mây của FPT Cloud: hệ thống được phân tán để tránh điểm nghẽn trung tâm, không để một database gánh mọi loại workload. Theo công bố của công ty, kiến trúc này giúp độ trễ xử lý lệnh giữ ổn định ở mức khoảng 5 mili giây khi khối lượng lệnh tăng gấp 10 lần.
Hiệu quả vận hành và giá trị thực tiễn cho nhà đầu tư
Giải pháp đã vượt qua giai đoạn thử nghiệm. Sau khoảng 1 năm chính thức ra mắt, tính tới tới hết Quý 2/2026, Lệnh AI đã thu hút gần 12.000 người dùng đăng ký sử dụng, với tổng giá trị giao dịch đạt 665 tỷ đồng. Với Trợ lý ảo Ensa, sau hơn 1 năm ra mắt, khoảng 1,8 triệu câu hỏi của nhà đầu tư đã được xử lý, bình quân gần 3.300 câu hỏi mỗi ngày, phục vụ hơn 91.000 người dùng.
Với nhà đầu tư, giá trị của Trợ lý ảo Ensa là cung cấp trải nghiệm tư vấn đầu tư toàn diện, chủ động trò chuyện, gợi mở thông tin giải pháp cho nhà đầu tư chủ động. Còn Lệnh AI mang đến 3 lợi ích giúp tối ưu quá trình đặt lệnh. Lệnh khối lượng lớn được chia nhỏ theo diễn biến thị trường, giảm rủi ro tự đẩy giá bất lợi và tối ưu giá khớp bình quân. Máy giám sát thị trường thay con người, nhà đầu tư bớt áp lực theo dõi bảng điện liên tục và giảm yếu tố cảm xúc khi quyết định. Việc AI trực tiếp đặt lệnh cũng giúp bảo mật chiến lược giao dịch, tránh bị đọc vị ý định mua bán khối lượng lớn.
Ở tầm thị trường, ý nghĩa của hướng đi này rộng hơn một tính năng. Công cụ thực thi lệnh thông minh vốn là đặc quyền của nhà đầu tư tổ chức đang được phổ cập cho nhà đầu tư cá nhân, đúng thời điểm thị trường Việt Nam chuẩn bị vận hành theo chuẩn mực mới nổi từ tháng 9/2026 và đón dòng vốn tổ chức quốc tế vốn đòi hỏi hạ tầng giao dịch ổn định, minh bạch hơn.
Nền dữ liệu phải vững trước khi AI mở rộng
AI đã đi vào sản phẩm khách hàng dùng hàng ngày và trực tiếp hành động trên dữ liệu vận hành thật. Vì vậy, DNSE xác định củng cố hạ tầng và nền tảng dữ liệu là trọng tâm đầu tư tiếp theo. Chia sẻ tại sự kiện Modern Architecture for the AI Era do FPT tổ chức, ông Nguyễn Đức Bình, Giám đốc Công nghệ DNSE, cho biết trước khi mở rộng quy mô ứng dụng AI, công ty đã rà soát và xử lý ba nhóm rủi ro dữ liệu.
Một là, cùng một khái niệm có thể mang nghĩa khác nhau tùy hệ thống. Trạng thái "Active" của khách hàng được CRM, Core Trading và hệ thống quản trị rủi ro hiểu theo ba cách khác nhau. AI đọc cả ba nguồn cùng lúc mà thiếu phản xạ đối chiếu sẽ nhận định sai. DNSE đang thống nhất định nghĩa cho từng thuật ngữ xuyên suốt các hệ thống, gán rõ chủ sở hữu định nghĩa và cơ chế cập nhật khi nghiệp vụ thay đổi.
Hai là, AI Agent có thể tiếp cận dữ liệu vượt phạm vi quyền hạn của người hỏi. Đội ngũ công nghệ chuyển từ kiểm tra quyền một lần ở cổng vào sang theo dõi quyền hạn xuyên suốt quá trình xử lý, kèm bước kiểm tra lại kết quả đầu ra trước khi trả về người dùng.
Ba là, cấu trúc dữ liệu (schema) có thể âm thầm thay đổi trong vận hành mà mô hình không được cập nhật, khiến AI suy luận trên nền dữ liệu đã sai lệch. Theo ông Bình, đây là điều đáng lo hơn một lỗi hiển nhiên, vì không ai nhận ra cho đến khi hậu quả xuất hiện. Audit trail (dấu vết kiểm toán) vì thế được đưa vào như yêu cầu thiết kế ngay từ đầu. Diễn tập phục hồi backup và kiểm soát thay đổi schema trở thành bước bắt buộc trước khi bất kỳ hệ thống AI nào chạy thật.
Phần lớn nguyên tắc kiến trúc đứng sau những thay đổi này đều không mới. Chúng là những nguyên tắc tốt đã tồn tại từ trước, nhưng khi triển khai AI thì chuyển từ khuyến nghị thành bắt buộc, ông Bình nhận định. Cách tiếp cận này khớp với bức tranh quốc tế: khảo sát của KPMG trên 1.013 lãnh đạo tài chính tại 20 quốc gia cho thấy 36% tổ chức xem chất lượng dữ liệu vừa là rào cản lớn nhất vừa là cơ hội lớn nhất của AI trong tài chính.
Khi trọng tâm cạnh tranh của ngành chuyển từ phí giao dịch sang năng lực công nghệ và dữ liệu, giá trị của một giải pháp AI không chỉ nằm ở tính năng nhà đầu tư nhìn thấy. Nó nằm ở nền tảng bảo đảm những quyết định tự động luôn chính xác và trong đúng phạm vi cho phép. Như ông Bình đúc kết: "AI không tạo ra những vấn đề. Nó chỉ khiến ta không còn giấu được chúng."
Hệ sinh thái AI-ready Data Platform của FPT Cloud
Những bài học từ DNSE cũng là điều FPT Cloud quan sát khi đồng hành cùng nhiều doanh nghiệp trong hành trình triển khai AI. Dù ở lĩnh vực tài chính, bán lẻ hay sản xuất, điểm chung đều không nằm ở việc lựa chọn mô hình AI nào, mà ở việc doanh nghiệp có một nền tảng dữ liệu đủ tin cậy để AI vận hành an toàn hay không.
Một nền tảng dữ liệu sẵn sàng cho AI thường được tổ chức theo ba lớp độc lập nhưng liên kết chặt chẽ, lớp vận hành thời gian thực phục vụ đa nguồn dữ liệu, lớp phân tích và báo cáo tách riêng để không cạnh tranh tài nguyên với lớp vận hành, và lớp trí tuệ nhân tạo được xây dựng trên nền tảng dữ liệu hợp nhất để huấn luyện mô hình. Một hệ thống AI không thất bại vì mô hình kém, mà thường thất bại vì hạ tầng dữ liệu phía dưới chưa phù hợp.
Đây cũng là cách FPT Cloud thiết kế hệ sinh thái AI-Ready Data Platform của mình, kết nối từ lớp hạ tầng điện toán (GPU, Cloud Server, lưu trữ), qua lớp nền tảng dữ liệu (thu thập, xử lý, lưu trữ với nhiều loại database engine phù hợp từng bài toán), đến lớp bảo mật và quản trị dữ liệu xuyên suốt toàn bộ vòng đời. Trong lớp nền tảng dữ liệu đó, FPT MongoDB Enterprise là dịch vụ cơ sở dữ liệu quản lý (DBaaS) đầu tiên tại Việt Nam được MongoDB chính thức chứng nhận, phù hợp cho các workload cần mô hình dữ liệu linh hoạt và khả năng mở rộng theo chiều ngang, một trong những đặc tính then chốt để một nền tảng dữ liệu thực sự sẵn sàng cho AI.
Liên hệ với chúng tôi để được tư vấn chi tiết về dịch vụ của FPT MongoDB Enterprise
Email: support@fptcloud.com
Support: m.me/fptsmartcloud